
Codex CLI avec des modèles dans l'UE : Kimi K3, GLM 5.3 et DeepSeek V4.1 Flash via un fournisseur personnalisé
 Niklas KarolyFondateur de Nodion
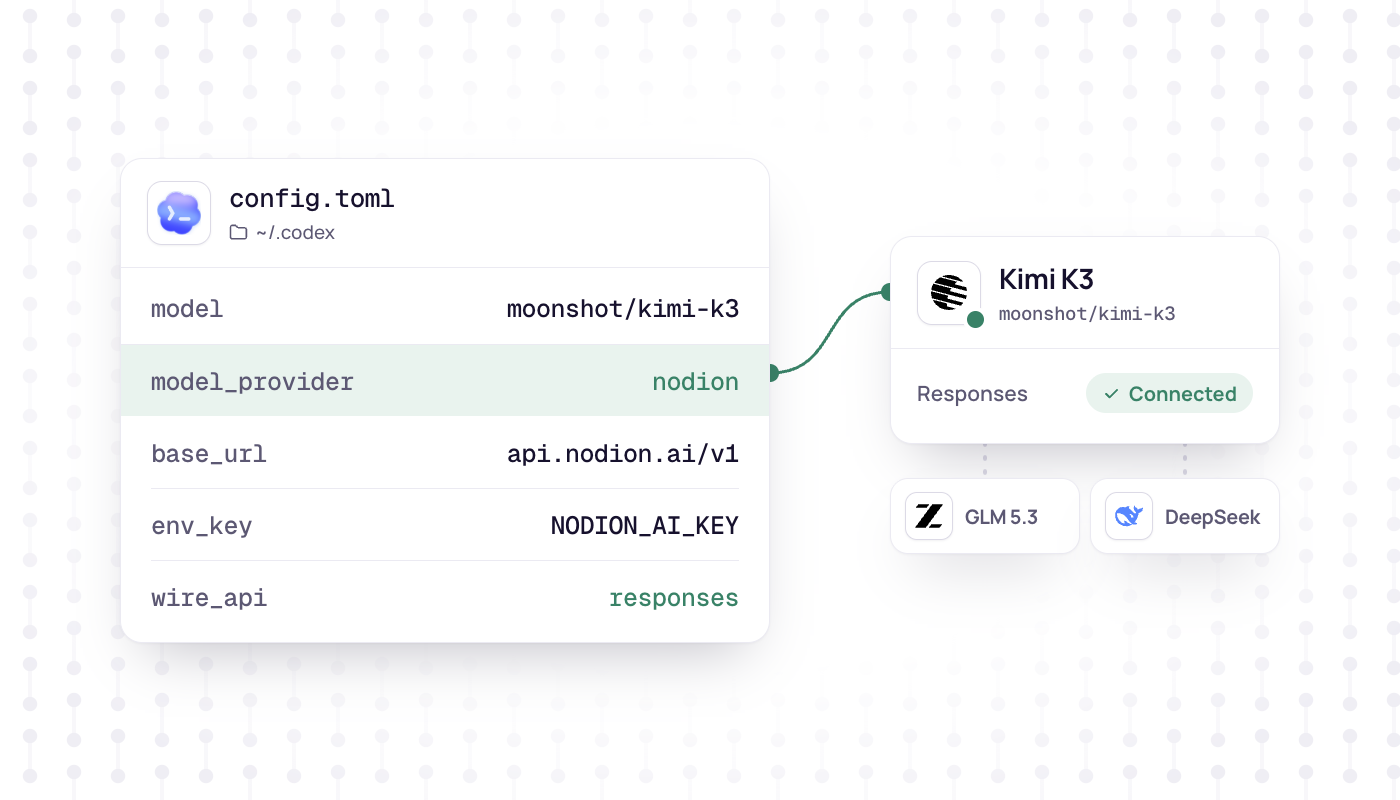
En bref
- Codex CLI fonctionne avec Nodion AI Gateway grâce à un fournisseur personnalisé dans
~/.codex/config.toml: URL de basehttps://api.nodion.ai/v1,env_key = "NODION_AI_KEY"etwire_api = "responses", la seule wire API que Codex accepte encore. - La passerelle route uniquement vers des fournisseurs basés dans l'UE, tous avec zero data retention, et Codex appelle Kimi K3, GLM 5.3 et DeepSeek V4.1 Flash avec votre clé d'API Nodion, sans compte chez les fournisseurs.
- Codex ne connaît pas ces ID de modèle et se rabat sur une fenêtre de contexte de 272 000 tokens, inférieure à la valeur du catalogue ; depuis Codex 0.134.0, chaque profil est un fichier séparé dans ~/.codex, et un .codex/config.toml de projet ne peut pas définir le fournisseur.
- Le
/v1/responsesde Nodion est sans état : Codex envoie toute la conversation à chaque requête, la recherche web fonctionne et aucune réponse n'est stockée ; les détails sont dans la référence de l'API IA.
Codex CLI peut dialoguer avec n'importe quel fournisseur qui sert l'API Responses d'OpenAI. Nodion AI Gateway, à l'adresse https://api.nodion.ai/v1, propose /v1/responses : un seul bloc de fournisseur dans ~/.codex/config.toml suffit donc pour faire tourner Codex avec Kimi K3, GLM 5.3 ou DeepSeek V4.1 Flash. La passerelle route uniquement vers des fournisseurs basés dans l'UE, tous avec zero data retention. Vous n'avez besoin d'aucun compte chez ces fournisseurs : Codex appelle tout avec votre clé d'API Nodion.
Ce guide suit la documentation de Codex à la release 0.165.0 (octobre 2026).
Ce dont vous avez besoin
- Un compte Nodion et un projet avec AI Inference.
- Une clé d'API : une clé d'inférence créée sous AI Inference → Keys (elle commence par
nodion_ai_et n'est affichée qu'une seule fois), ou une clé créée dans le cadre de votre AI Coding Plan. Les clés de l'API de la plateforme Nodion ne fonctionnent pas ici. - Du crédit sur le solde prépayé, sauf si la clé est rattachée à une offre de la gamme AI Coding Plans.
- Codex CLI. Les fichiers de profil présentés plus bas nécessitent la version 0.134.0 ou ultérieure.
Définissez la clé dans le shell qui lance Codex :
export NODION_AI_KEY=nodion_ai_your_keyAjouter Nodion comme fournisseur personnalisé
Ouvrez ~/.codex/config.toml et ajoutez :
# ~/.codex/config.toml
model = "moonshot/kimi-k3"
model_provider = "nodion"

[model_providers.nodion]
name = "Nodion"
base_url = "https://api.nodion.ai/v1"
env_key = "NODION_AI_KEY"
wire_api = "responses"modelest l'identifiant du modèle dans le catalogue Nodion, slash compris.model_providersélectionne le bloc ci-dessous. Les identifiantsopenai,ollamaetlmstudiosont réservés : le fournisseur a donc besoin de son propre identifiant.env_keyindique la variable d'environnement qui contient la clé. Les fournisseurs personnalisés n'utilisent pas la connexion OpenAI, sauf si vous définissezrequires_openai_auth.wire_api = "responses"est la seule valeur acceptée par Codex, et la valeur par défaut. Codex rejette les anciennes configurations avecwire_api = "chat"dès qu'il les lit :`wire_api = "chat"` is no longer supported.
Sources, vérifiées en octobre 2026 : référence de configuration de Codex, discussion #7782, model-provider-info.
Choisir un modèle
Voici trois modèles de chat proposés dans les AI Coding Plans, tous compatibles avec les outils (tools) et le raisonnement :
| Modèle | Identifiant | Entrée | Contexte (catalogue) | Sortie max. |
|---|---|---|---|---|
| Kimi K3 | moonshot/kimi-k3 | Texte, image, vidéo | 1 048 576 | 32 768 |
| GLM 5.3 | z-ai/glm-5.3 | Texte | 1 048 576 | 131 072 |
| DeepSeek V4.1 Flash | deepseek/deepseek-v4.1-flash | Texte, image | 1 048 576 | 393 216 |
Changez de modèle pour une session avec -m (--model) ; le fournisseur reste celui de votre configuration :
codex -m z-ai/glm-5.3
codex -m deepseek/deepseek-v4.1-flash
Les profils sont désormais des fichiers séparés
Depuis Codex 0.134.0, --profile ne lit plus les tables [profiles.name] de config.toml. Chaque profil est un fichier à part, ~/.codex/<name>.config.toml, avec des clés de premier niveau que Codex superpose à votre configuration de base. Gardez le bloc de fournisseur dans config.toml et créez un profil par modèle :
# ~/.codex/nodion-glm.config.toml
model = "z-ai/glm-5.3"
model_provider = "nodion"
codex --profile nodion-glm
codex exec --profile nodion-glm "Summarize the open TODOs in this repo"Les configurations de projet ne peuvent pas définir le fournisseur
Codex lit un .codex/config.toml à l'intérieur d'un dépôt pour les projets de confiance, mais il y ignore model_provider et model_providers et affiche un avertissement au démarrage. Le bloc de fournisseur a donc sa place dans ~/.codex/config.toml ou dans un fichier de profil. Si vos réglages semblent sans effet, /debug-config montre quelles couches de configuration Codex a chargées.
Sources : configuration avancée de Codex, bases de la configuration de Codex, commandes slash.
La limite de la fenêtre de contexte
Codex n'a pas de métadonnées intégrées pour ces identifiants de modèle. Il affiche Unknown model moonshot/kimi-k3 is used. This will use fallback model metadata. et travaille avec une fenêtre de contexte de 272 000 tokens. model_context_window peut abaisser cette valeur, mais pas l'augmenter. Dans Codex, le contexte utilisable reste donc inférieur aux 1 048 576 tokens que le catalogue indique pour les trois modèles. L'avertissement lui-même est normal.
Source : model_info.rs dans le dépôt de Codex.
Vérifier la configuration
Lancez codex dans un dépôt et exécutez /status. La commande affiche la configuration de la session : le modèle actif, la politique d'approbation, les répertoires accessibles en écriture et le contexte restant. Cela ne prouve pas qu'un appel est passé : envoyez donc un premier prompt, par exemple « Expliquez en deux phrases ce que fait ce dépôt. » Si une réponse arrive, la clé, l'URL de base et l'identifiant du modèle fonctionnent. Les onglets Usage et Requests d'AI Inference montrent le trafic.
Ce qu'implique l'endpoint /v1/responses sans état
- Rien n'est stocké. Nodion ne stocke aucune réponse :
storeest ignoré et la réponse indiquestore: false. Il n'y a pas deprevious_response_id, deconversationni deGET /v1/responses/{id}. Codex envoie toute la conversation dansinputà chaque requête, il n'en a donc pas besoin. - Les longues sessions coûtent plus cher par tour. Chaque requête transporte toute la conversation jusque-là, donc les tokens d'entrée augmentent avec la session. L'entrée mise en cache est facturée au prix du cache lorsque la route le signale.
- La recherche web fonctionne. La passerelle exécute elle-même
web_searchvia la recherche web de Nodion et renvoie la requête et les URL des sources dans un élémentweb_search_call. La recherche renvoie des résultats d'index (titre, URL, extrait) et n'ouvre aucune page. Par défaut, elle effectue au maximum 10 recherches par réponse (jusqu'à 20 avecmax_tool_calls). - Outils :
function,custom,namespaceetweb_search. Les autres outils hébergés sont rejetés. - Les sorties d'outils sont du texte. Les images et les fichiers contenus dans les sorties d'outils n'atteignent pas le modèle ; une note dans le texte les remplace.
Facturation : solde prépayé ou offre de code IA
Une clé qui n'est pas rattachée à une offre utilise le solde prépayé : tokens d'entrée et de sortie au prix du modèle. Chaque recherche web est facturée comme un appel à l'outil de recherche web, et chaque appel au modèle comme une complétion de chat. Une clé rattachée à une offre de la gamme AI Coding Plans (Go, Pro ou Max) utilise plutôt l'usage inclus dans l'offre pour le chat et les outils. Cet usage est décompté sur une fenêtre de 5 heures, une fenêtre hebdomadaire et une fenêtre mensuelle. Quand l'une d'elles est pleine, les requêtes continuent sur le solde prépayé seulement si l'offre autorise l'usage du solde. Les prix par modèle figurent sur les pages des modèles sous AI Inference, et les prix des offres sur AI Coding Plans.
Dépannage
- 401 : la clé manque ou n'est pas du bon type. Les clés de la plateforme (
nodion_…) ne fonctionnent pas sur cette API. Utilisez une clé d'inférence (nodion_ai_…) ou une clé de votre offre de code IA, et vérifiez queNODION_AI_KEYest exportée dans le shell qui lance Codex. - 400 pour un outil : les outils hébergés autres que
web_search, commefile_searchoucode_interpreter, sont rejetés avec une erreur 400. C'est aussi le cas debackground,prompt,truncation: "auto",file_idetfile_url. - 404
model not found: l'identifiant du modèle est erroné.curl https://api.nodion.ai/v1/modelsliste les identifiants exacts et ne nécessite pas de clé. - 402 : le solde prépayé ne couvre pas la requête, ou une limite de dépenses a été atteinte. Rechargez votre solde dans l'onglet Billing ou vérifiez la limite journalière de la clé.
- 503 : aucune route opérationnelle pour le modèle ne correspond aux réglages IA du projet, par exemple parce que ses fournisseurs y sont exclus.
Sources : référence de l'API IA : API Responses, erreurs et limites, documentation AI Inference, AI Coding Plans.
Étapes suivantes
- Tous les champs de l'API Responses sur Nodion : référence de l'API IA.
- Vous préférez OpenCode ? OpenCode avec Kimi K3 et GLM 5.3. Pour Aider, Cline et Continue : Aider, Cline et Continue avec des modèles dans l'UE.
- Un forfait mensuel pour les agents de codage IA : AI Coding Plans.
Questions fréquentes
Codex CLI peut-il utiliser d'autres modèles que ceux d'OpenAI ?
Oui. Codex prend en charge les fournisseurs personnalisés qui servent l'API Responses d'OpenAI. Avec un bloc model_providers pour https://api.nodion.ai/v1, il fonctionne avec Kimi K3, GLM 5.3 ou DeepSeek V4.1 Flash via Nodion AI Gateway, qui route uniquement vers des fournisseurs basés dans l'UE.
Codex CLI prend-il encore en charge wire_api = "chat" ?
Non. Codex rejette wire_api = "chat" à la lecture de la configuration. "responses" est la seule valeur prise en charge et la valeur par défaut : un fournisseur personnalisé doit donc servir l'API Responses.
Pourquoi la fenêtre de contexte est-elle plus petite dans Codex que celle du modèle ?
Codex n'a pas de métadonnées pour les ID de modèle qu'il ne connaît pas et se rabat sur une fenêtre de 272 000 tokens. Le réglage model_context_window peut abaisser cette valeur, mais pas l'augmenter.
Puis-je payer l'usage de Codex avec un AI Coding Plan ?
Oui. Une clé créée dans le cadre d'une offre AI Coding Plans de Nodion utilise l'usage inclus dans l'offre pour le chat et les outils, décompté sur des fenêtres de 5 heures, hebdomadaires et mensuelles. Les clés sans offre sont facturées sur le solde prépayé.