
Codex CLI con modelos en la UE: Kimi K3, GLM 5.3 y DeepSeek V4.1 Flash con un proveedor personalizado
 Niklas KarolyFundador de Nodion
En resumen
- Codex CLI funciona con el Nodion AI Gateway mediante un proveedor personalizado en
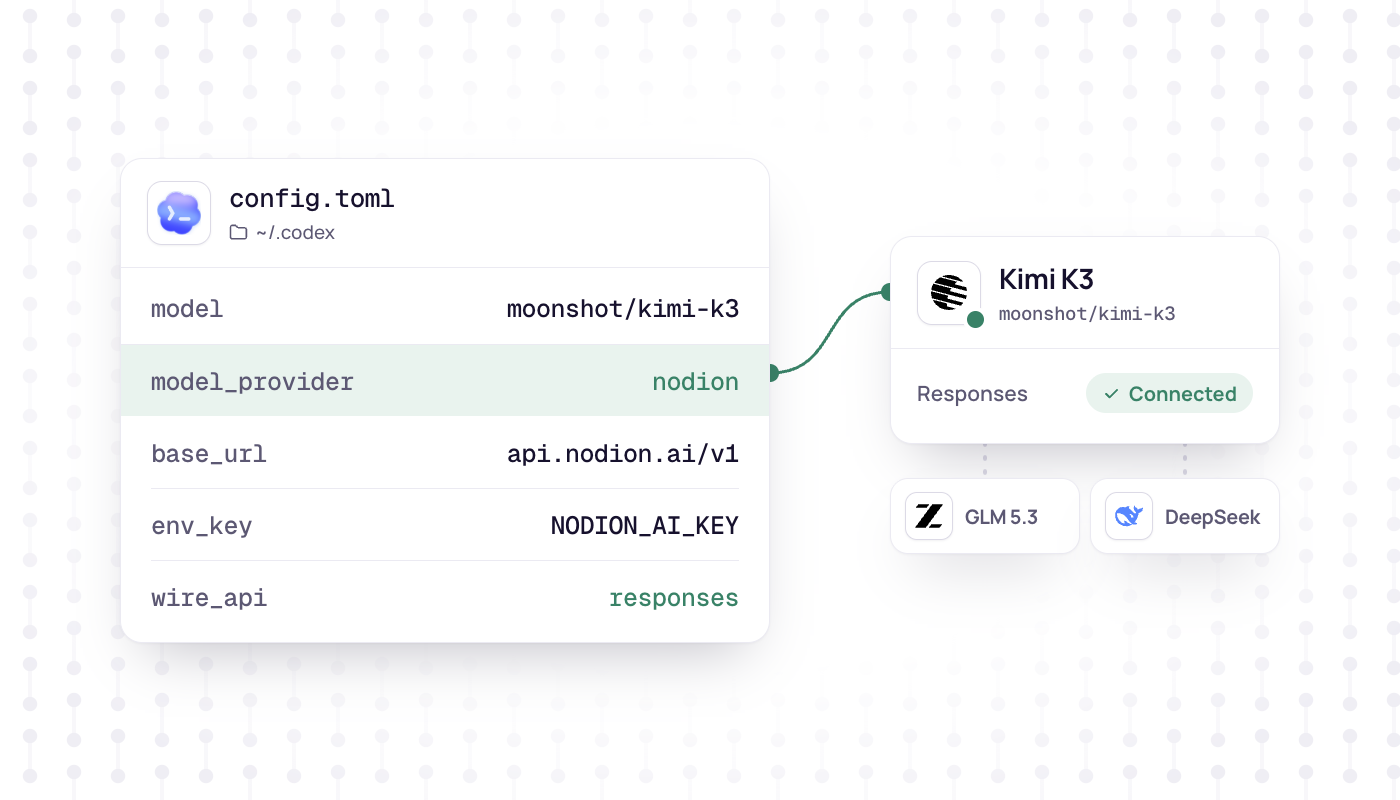
~/.codex/config.toml: URL basehttps://api.nodion.ai/v1,env_key = "NODION_AI_KEY"ywire_api = "responses", la única wire API que Codex sigue aceptando. - El gateway solo enruta a proveedores con sede en la UE, todos con zero data retention, y Codex llama a Kimi K3, GLM 5.3 y DeepSeek V4.1 Flash con tu clave de API de Nodion, sin cuenta en los proveedores.
- Codex no conoce estos IDs de modelo y recurre a una ventana de contexto de 272.000 tokens, por debajo del valor del catálogo; desde Codex 0.134.0 cada perfil es un archivo aparte en ~/.codex, y un .codex/config.toml de proyecto no puede definir el proveedor.
- El
/v1/responsesde Nodion no tiene estado: Codex envía toda la conversación en cada petición, la búsqueda web funciona y no se guarda ninguna respuesta; los detalles están en la referencia de la API de IA.
Codex CLI puede conectarse a cualquier proveedor que ofrezca la OpenAI Responses API. El Nodion AI Gateway, disponible en https://api.nodion.ai/v1, ofrece /v1/responses, así que basta con un bloque de proveedor en ~/.codex/config.toml para usar Codex con Kimi K3, GLM 5.3 o DeepSeek V4.1 Flash. El gateway solo enruta a proveedores con sede en la UE, todos con zero data retention. No necesitas cuenta en esos proveedores: Codex hace todas las llamadas con tu clave de API de Nodion.
Esta guía sigue la documentación de Codex correspondiente a la release 0.165.0 (octubre de 2026).
Qué necesitas
- Una cuenta de Nodion y un proyecto con AI Inference.
- Una clave de API: una clave de inferencia de AI Inference → Keys (empieza por
nodion_ai_y se muestra una sola vez) o una clave que crees en tu AI Coding Plan. Las claves de la API de la plataforma Nodion no sirven aquí. - Crédito en tu saldo prepago, salvo que la clave esté en un coding plan.
- Codex CLI. Los archivos de perfil de más abajo necesitan la 0.134.0 o posterior.
Define la clave en la shell que ejecuta Codex:
export NODION_AI_KEY=nodion_ai_your_keyAñade Nodion como proveedor personalizado
Abre ~/.codex/config.toml y añade:
# ~/.codex/config.toml
model = "moonshot/kimi-k3"
model_provider = "nodion"

[model_providers.nodion]
name = "Nodion"
base_url = "https://api.nodion.ai/v1"
env_key = "NODION_AI_KEY"
wire_api = "responses"modeles el ID del modelo del catálogo de Nodion, con la barra incluida.model_providerselecciona el bloque de abajo. Los IDsopenai,ollamaylmstudioestán reservados, así que el proveedor necesita su propio ID.env_keyindica la variable de entorno que contiene la clave. Los proveedores personalizados se saltan el inicio de sesión de OpenAI salvo que configuresrequires_openai_auth.wire_api = "responses"es el único valor que acepta Codex y también el predeterminado. Codex rechaza las configuraciones antiguas conwire_api = "chat"al cargarlas:`wire_api = "chat"` is no longer supported.
Fuentes, consultadas en octubre de 2026: referencia de configuración de Codex, discusión #7782, model-provider-info.
Elige un modelo
Tres modelos de chat de la lista de AI Coding Plans, todos con herramientas y razonamiento:
| Modelo | ID | Entrada | Contexto (catálogo) | Salida máxima |
|---|---|---|---|---|
| Kimi K3 | moonshot/kimi-k3 | Texto, imagen, vídeo | 1.048.576 | 32.768 |
| GLM 5.3 | z-ai/glm-5.3 | Texto | 1.048.576 | 131.072 |
| DeepSeek V4.1 Flash | deepseek/deepseek-v4.1-flash | Texto, imagen | 1.048.576 | 393.216 |
Cambia de modelo para una sesión con -m (--model); el proveedor sigue siendo el de tu configuración:
codex -m z-ai/glm-5.3
codex -m deepseek/deepseek-v4.1-flash
Los perfiles ahora son archivos separados
Desde Codex 0.134.0, --profile ya no lee las tablas [profiles.name] de config.toml. Cada perfil es su propio archivo, ~/.codex/<name>.config.toml, con claves de nivel superior que Codex superpone a tu configuración base. Deja el bloque del proveedor en config.toml y crea un perfil por modelo:
# ~/.codex/nodion-glm.config.toml
model = "z-ai/glm-5.3"
model_provider = "nodion"
codex --profile nodion-glm
codex exec --profile nodion-glm "Summarize the open TODOs in this repo"Las configuraciones de proyecto no pueden definir el proveedor
En los proyectos de confianza, Codex lee un .codex/config.toml dentro del repositorio, pero ahí ignora model_provider y model_providers y muestra un aviso al arrancar. Por eso, el bloque del proveedor va en ~/.codex/config.toml o en un archivo de perfil. Si parece que tus ajustes no tienen efecto, /debug-config muestra qué capas de configuración ha cargado Codex.
Fuentes: configuración avanzada de Codex, conceptos básicos de configuración de Codex, comandos slash.
El límite de la ventana de contexto
Codex no tiene metadatos integrados para estos IDs de modelo. Muestra Unknown model moonshot/kimi-k3 is used. This will use fallback model metadata. y trabaja con una ventana de contexto de 272.000 tokens. model_context_window puede bajar ese valor, pero no subirlo. Así que en Codex el contexto utilizable se queda por debajo de los 1.048.576 tokens que el catálogo indica para los tres modelos. El aviso en sí es normal.
Fuente: model_info.rs en el repositorio de Codex.
Comprueba la configuración
Arranca codex en un repositorio y ejecuta /status. Muestra la configuración de la sesión: el modelo activo, la política de aprobación, las rutas con permiso de escritura y el contexto restante. Eso no demuestra que una llamada haya funcionado, así que envía un primer prompt, por ejemplo “Explica en dos frases qué hace este repositorio”. Si llega una respuesta, la clave, la URL base y el ID del modelo funcionan. Las pestañas Usage y Requests de AI Inference muestran el tráfico.
Qué implica usar /v1/responses sin estado
- No se guarda nada. Nodion no guarda respuestas:
storese ignora y la respuesta indicastore: false. No hayprevious_response_id,conversationniGET /v1/responses/{id}. Codex envía toda la conversación eninputcon cada petición, así que no los necesita. - Las sesiones largas cuestan más por turno. Cada petición lleva la conversación hasta ese momento, así que los tokens de entrada crecen con la sesión. La entrada en caché se factura al precio de caché cuando la ruta lo informa.
- La búsqueda web funciona. El gateway ejecuta
web_searchpor sí mismo a través de la búsqueda web de Nodion y devuelve la consulta y las URL de las fuentes en un elementoweb_search_call. La búsqueda devuelve resultados del índice (título, URL, fragmento) y no abre ninguna página. Por defecto, como máximo 10 búsquedas por respuesta (max_tool_calls, hasta 20). - Herramientas:
function,custom,namespaceyweb_search. Las demás herramientas alojadas (hosted tools) se rechazan. - Las salidas de las herramientas son texto. Las imágenes y los archivos dentro de las salidas de herramientas no llegan al modelo; en su lugar aparece una nota en el texto.
Facturación: saldo o coding plan
El uso de una clave que no está en un plan se factura con cargo al saldo prepago: tokens de entrada y salida al precio del modelo. Cada búsqueda web se factura como una llamada a la herramienta de búsqueda web, y cada ronda del modelo como un chat completion. En cambio, una clave en un AI Coding Plan (Go, Pro o Max) consume el uso incluido en el plan para chat y herramientas. Ese uso se computa en una ventana de 5 horas, otra semanal y otra mensual. Cuando se agota uno de esos límites, las peticiones siguen con cargo al saldo solo si el plan permite usarlo. Los precios por modelo están en las páginas de modelo de AI Inference, y los planes, en AI Coding Plans.
Solución de problemas
- 401: falta la clave o es de un tipo equivocado. Las claves de la plataforma (
nodion_…) no funcionan en esta API. Usa una clave de inferencia (nodion_ai_…) o una clave de tu coding plan, y comprueba queNODION_AI_KEYesté exportada en la shell que arranca Codex. - 400 por una herramienta: las herramientas alojadas distintas de
web_search, comofile_searchocode_interpreter, se rechazan con un 400. Lo mismo ocurre conbackground,prompt,truncation: "auto",file_idyfile_url. - 404
model not found: el ID del modelo es incorrecto.curl https://api.nodion.ai/v1/modelslista los IDs exactos y no necesita clave. - 402: el saldo no cubre la petición o se ha alcanzado un límite de gasto. Recarga el saldo en la pestaña Billing o revisa el límite diario de la clave.
- 503: ninguna ruta operativa del modelo cumple los ajustes de IA del proyecto, por ejemplo porque sus proveedores están excluidos ahí.
Fuentes: referencia de la API de IA: Responses API, errores y límites, documentación de AI Inference, AI Coding Plans.
Próximos pasos
- Todos los campos de la Responses API en Nodion: referencia de la API de IA.
- ¿Prefieres OpenCode? OpenCode con Kimi K3 y GLM 5.3. Para Aider, Cline y Continue: Aider, Cline y Continue con modelos en la UE.
- Un paquete mensual para agentes de programación: AI Coding Plans.
Preguntas frecuentes
¿Puede Codex CLI usar modelos que no sean de OpenAI?
Sí. Codex admite proveedores personalizados que sirvan la OpenAI Responses API. Con un bloque model_providers para https://api.nodion.ai/v1 funciona con Kimi K3, GLM 5.3 o DeepSeek V4.1 Flash a través del Nodion AI Gateway, que solo enruta a proveedores con sede en la UE.
¿Codex CLI sigue admitiendo wire_api = "chat"?
No. Codex rechaza wire_api = "chat" al leer la configuración. "responses" es el único valor admitido y el predeterminado, así que un proveedor personalizado tiene que servir la Responses API.
¿Por qué la ventana de contexto en Codex es más pequeña que la del modelo?
Codex no tiene metadatos para los IDs de modelo que no conoce y recurre a una ventana de 272.000 tokens. El ajuste model_context_window puede bajar ese valor, pero no subirlo.
¿Puedo pagar el uso de Codex con un AI Coding Plan?
Sí. Una clave creada en un AI Coding Plan de Nodion consume el uso incluido en el plan para chat y herramientas, que cuenta para ventanas de 5 horas, semanales y mensuales. Las claves sin plan pagan con el saldo prepago.