
Codex CLI com modelos na UE: Kimi K3, GLM 5.3 e DeepSeek V4.1 Flash através de um fornecedor personalizado
 Niklas KarolyFundador da Nodion
Em resumo
- O Codex CLI funciona com o Nodion AI Gateway através de um fornecedor personalizado em
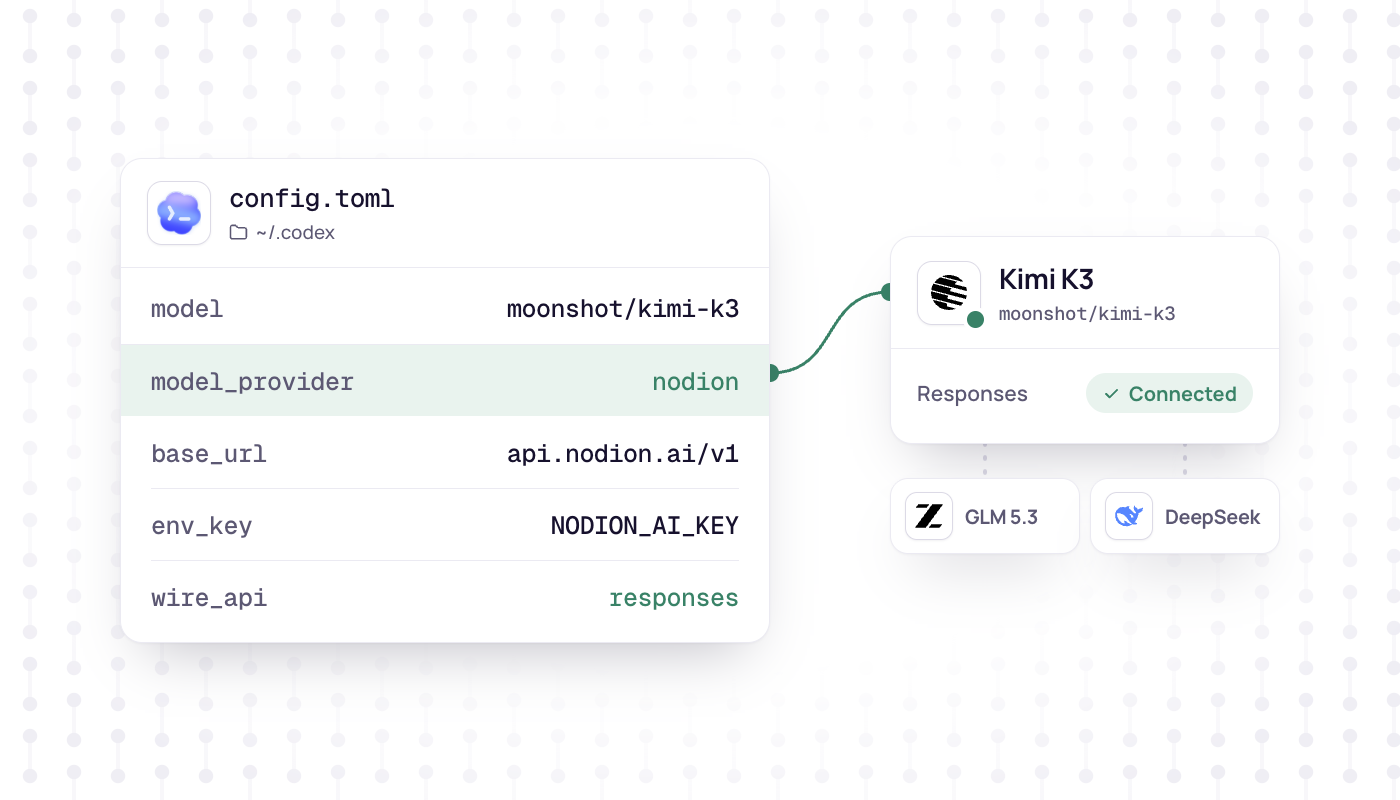
~/.codex/config.toml: URL basehttps://api.nodion.ai/v1,env_key = "NODION_AI_KEY"ewire_api = "responses", a única wire API que o Codex ainda aceita. - O gateway encaminha pedidos apenas para fornecedores sediados na UE, todos com zero data retention, e o Codex chama Kimi K3, GLM 5.3 e DeepSeek V4.1 Flash com a sua chave de API da Nodion, sem conta nos fornecedores.
- O Codex não conhece estes IDs de modelo e recorre a uma janela de contexto de 272 000 tokens, abaixo do valor do catálogo; desde o Codex 0.134.0, cada perfil é um ficheiro separado em ~/.codex, e um .codex/config.toml de projeto não pode definir o fornecedor.
- O
/v1/responsesda Nodion não tem estado: o Codex envia a conversa completa em cada pedido, a pesquisa na web funciona e nenhuma resposta é guardada; os detalhes estão na referência da API de IA.
O Codex CLI pode comunicar com qualquer fornecedor que disponibilize a API Responses da OpenAI. O Nodion AI Gateway, em https://api.nodion.ai/v1, oferece /v1/responses, pelo que basta um bloco de fornecedor em ~/.codex/config.toml para usar o Codex com Kimi K3, GLM 5.3 ou DeepSeek V4.1 Flash. O gateway encaminha pedidos apenas para fornecedores sediados na UE, todos com zero data retention. Não precisa de conta nesses fornecedores: o Codex faz todas as chamadas com a sua chave de API da Nodion.
Este guia segue a documentação do Codex para a versão 0.165.0 (outubro de 2026).
Do que precisa
- Uma conta Nodion e um projeto com AI Inference.
- Uma chave de API: uma chave de inferência criada em AI Inference → Keys (começa por
nodion_ai_e só é mostrada uma vez) ou uma chave criada no seu AI Coding Plan. As chaves da API da plataforma da Nodion não funcionam aqui. - Saldo pré-pago disponível, exceto se a chave pertencer a um AI Coding Plan.
- Codex CLI. Os ficheiros de perfil descritos mais abaixo exigem a versão 0.134.0 ou posterior.
Defina a chave na shell que executa o Codex:
export NODION_AI_KEY=nodion_ai_your_keyAdicionar a Nodion como fornecedor personalizado
Abra ~/.codex/config.toml e adicione:
# ~/.codex/config.toml
model = "moonshot/kimi-k3"
model_provider = "nodion"

[model_providers.nodion]
name = "Nodion"
base_url = "https://api.nodion.ai/v1"
env_key = "NODION_AI_KEY"
wire_api = "responses"modelé o ID do modelo no catálogo da Nodion, incluindo a barra.model_providerseleciona o bloco abaixo. Os IDsopenai,ollamaelmstudioestão reservados, por isso o fornecedor precisa do seu próprio ID.env_keyindica a variável de ambiente que contém a chave. Os fornecedores personalizados dispensam o início de sessão na OpenAI, a menos que definarequires_openai_auth.wire_api = "responses"é o único valor que o Codex aceita, e também o valor por omissão. O Codex rejeita configurações antigas comwire_api = "chat"ao lê-las:`wire_api = "chat"` is no longer supported.
Fontes, verificadas em outubro de 2026: referência de configuração do Codex, discussão #7782, model-provider-info.
Escolher um modelo
Três modelos de chat da lista dos AI Coding Plans, todos com suporte para ferramentas (tools) e raciocínio:
| Modelo | ID | Entrada | Contexto (catálogo) | Saída máx. |
|---|---|---|---|---|
| Kimi K3 | moonshot/kimi-k3 | Texto, imagem, vídeo | 1 048 576 | 32 768 |
| GLM 5.3 | z-ai/glm-5.3 | Texto | 1 048 576 | 131 072 |
| DeepSeek V4.1 Flash | deepseek/deepseek-v4.1-flash | Texto, imagem | 1 048 576 | 393 216 |
Para mudar de modelo numa única sessão, use -m (--model); o fornecedor continua a ser o da sua configuração:
codex -m z-ai/glm-5.3
codex -m deepseek/deepseek-v4.1-flash
Os perfis são agora ficheiros separados
Desde o Codex 0.134.0, --profile deixou de ler tabelas [profiles.name] de config.toml. Cada perfil é um ficheiro próprio, ~/.codex/<name>.config.toml, com chaves de nível superior que o Codex sobrepõe à sua configuração base. Mantenha o bloco de fornecedor em config.toml e crie um perfil por modelo:
# ~/.codex/nodion-glm.config.toml
model = "z-ai/glm-5.3"
model_provider = "nodion"
codex --profile nodion-glm
codex exec --profile nodion-glm "Summarize the open TODOs in this repo"A configuração do projeto não pode definir o fornecedor
Em projetos de confiança, o Codex lê o ficheiro .codex/config.toml no repositório, mas ignora aí model_provider e model_providers e mostra um aviso ao arrancar. Por isso, o bloco de fornecedor deve ficar em ~/.codex/config.toml ou num ficheiro de perfil. Se as suas definições parecerem não ter efeito, /debug-config mostra que camadas de configuração o Codex carregou.
Fontes: configuração avançada do Codex, noções básicas de configuração do Codex, comandos slash.
A limitação da janela de contexto
O Codex não tem metadados integrados para estes IDs de modelo. Mostra Unknown model moonshot/kimi-k3 is used. This will use fallback model metadata. e usa uma janela de contexto de 272 000 tokens. model_context_window pode baixar esse valor, mas não aumentá-lo. No Codex, o contexto utilizável fica, portanto, abaixo dos 1 048 576 tokens que o catálogo indica para os três modelos. O aviso em si é normal.
Fonte: model_info.rs no repositório do Codex.
Verificar a configuração
Inicie o codex num repositório e execute /status. O comando mostra a configuração da sessão: o modelo ativo, a política de aprovação (approval policy), as pastas com permissão de escrita e o contexto restante. Isso não confirma que uma chamada chegou ao destino, por isso envie um primeiro prompt, por exemplo «Explique em duas frases o que faz este repositório». Se chegar uma resposta, a chave, o URL base e o ID do modelo funcionam. Os separadores Usage e Requests do AI Inference mostram o tráfego.
O que significa, na prática, um /v1/responses sem estado
- Nada é guardado. A Nodion não guarda respostas:
storeé ignorado e a resposta indicastore: false. Não existeprevious_response_id,conversationnemGET /v1/responses/{id}. O Codex envia a conversa completa eminputem cada pedido, por isso não precisa deles. - As sessões longas custam mais por turno. Cada pedido leva toda a conversa até esse momento, por isso os tokens de entrada crescem com a sessão. Os tokens de entrada em cache são faturados ao preço de cache quando a rota o reporta.
- A pesquisa na web funciona. O próprio gateway executa
web_searchatravés da pesquisa na web da Nodion e devolve a consulta e os URLs das fontes num itemweb_search_call. A pesquisa devolve resultados do índice (título, URL, excerto) e não abre páginas. Por omissão, faz no máximo 10 pesquisas por resposta (max_tool_calls, até 20). - Ferramentas:
function,custom,namespaceeweb_search. As outras ferramentas alojadas são rejeitadas. - Os resultados das ferramentas são texto. Imagens e ficheiros nos resultados das ferramentas não chegam ao modelo; uma nota no texto substitui-os.
Faturação: saldo pré-pago ou AI Coding Plan
Uma chave que não pertence a um plano paga a partir do saldo pré-pago: tokens de entrada e de saída ao preço do modelo. Cada pesquisa na web é faturada como uma chamada à ferramenta de pesquisa na web, e cada turno do modelo como uma chat completion. Uma chave de um AI Coding Plan (Go, Pro ou Max) usa antes a utilização incluída no plano para chat e ferramentas. Essa utilização conta para uma janela de 5 horas, uma semanal e uma mensal. Quando um desses limites se esgota, os pedidos só continuam a partir do saldo se o plano permitir usar o saldo. Os preços por modelo estão nas páginas dos modelos em AI Inference e os planos em AI Coding Plans.
Resolução de problemas
- 401: a chave está em falta ou é do tipo errado. As chaves da plataforma (
nodion_…) não funcionam nesta API. Use uma chave de inferência (nodion_ai_…) ou uma chave do seu plano e verifique seNODION_AI_KEYestá exportada na shell que inicia o Codex. - 400 para uma ferramenta: as ferramentas alojadas que não sejam
web_search, comofile_searchoucode_interpreter, são rejeitadas com 400. O mesmo acontece combackground,prompt,truncation: "auto",file_idefile_url. - 404
model not found: o ID do modelo está errado.curl https://api.nodion.ai/v1/modelslista os IDs exatos e não precisa de chave. - 402: o saldo não cobre o pedido ou foi atingido um limite de gastos. Carregue o saldo no separador Billing ou verifique o limite diário da chave.
- 503: nenhuma rota operacional para o modelo corresponde às definições de IA do projeto, por exemplo porque os respetivos fornecedores estão aí excluídos.
Fontes: referência da API de IA: API Responses, erros e limites, documentação do AI Inference, AI Coding Plans.
Próximos passos
- Todos os campos da API Responses na Nodion: referência da API de IA.
- Prefere o OpenCode? OpenCode com Kimi K3 e GLM 5.3. Para Aider, Cline e Continue: Aider, Cline e Continue com modelos na UE.
- Um pacote mensal para agentes de programação: AI Coding Plans.
Perguntas frequentes
O Codex CLI pode usar modelos que não sejam da OpenAI?
Sim. O Codex suporta fornecedores personalizados que disponibilizam a API Responses da OpenAI. Com um bloco model_providers para https://api.nodion.ai/v1, funciona com Kimi K3, GLM 5.3 ou DeepSeek V4.1 Flash através do Nodion AI Gateway, que encaminha pedidos apenas para fornecedores sediados na UE.
O Codex CLI ainda suporta wire_api = "chat"?
Não. O Codex rejeita wire_api = "chat" ao ler a configuração. "responses" é o único valor suportado e o valor por omissão, por isso um fornecedor personalizado tem de disponibilizar a API Responses.
Porque é que a janela de contexto no Codex é menor do que a do modelo?
O Codex não tem metadados para IDs de modelo que não conhece e recorre a uma janela de 272 000 tokens. A definição model_context_window pode baixar esse valor, mas não aumentá-lo.
Posso pagar a utilização do Codex com um AI Coding Plan?
Sim. Uma chave criada num AI Coding Plan da Nodion usa a utilização incluída no plano para chat e ferramentas, contabilizada em janelas de 5 horas, semanais e mensais. As chaves sem plano pagam a partir do saldo pré-pago.