
Codex CLI z modelami z UE: Kimi K3, GLM 5.3 i DeepSeek V4.1 Flash przez własnego dostawcę
 Niklas KarolyZałożyciel Nodion
W skrócie
- Codex CLI działa z Nodion AI Gateway dzięki własnemu dostawcy w
~/.codex/config.toml: bazowy URLhttps://api.nodion.ai/v1,env_key = "NODION_AI_KEY"iwire_api = "responses", czyli jedyne wire API obsługiwane obecnie przez Codex. - Bramka AI kieruje żądania wyłącznie do dostawców z siedzibą w UE, wszystkich z zero data retention, a Codex wywołuje Kimi K3, GLM 5.3 i DeepSeek V4.1 Flash z Twoim kluczem API Nodion, bez konta u dostawców.
- Codex nie zna tych identyfikatorów modeli i przyjmuje domyślne okno kontekstu 272 000 tokenów, mniejsze niż okno podane w katalogu; od Codex 0.134.0 każdy profil to osobny plik w ~/.codex, a plik .codex/config.toml projektu nie może ustawić dostawcy.
- Endpoint
/v1/responsesw Nodion jest bezstanowy: Codex wysyła całą rozmowę przy każdym żądaniu, wyszukiwanie w sieci działa, a żadna odpowiedź nie jest przechowywana; szczegóły znajdziesz w dokumentacji API AI.
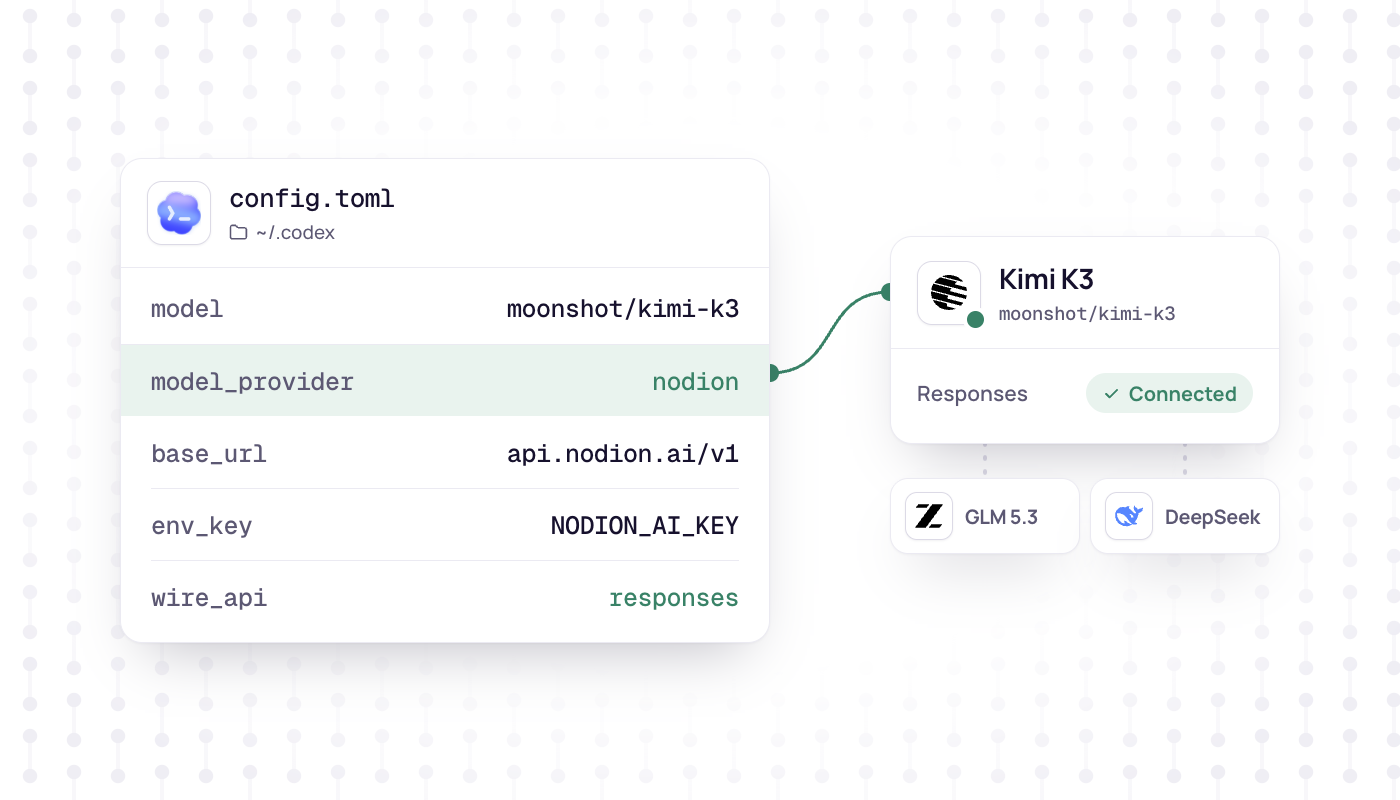
Codex CLI może współpracować z każdym dostawcą, który udostępnia OpenAI Responses API. Nodion AI Gateway pod adresem https://api.nodion.ai/v1 oferuje /v1/responses, więc jeden blok dostawcy w ~/.codex/config.toml wystarczy, aby uruchomić Codex z Kimi K3, GLM 5.3 lub DeepSeek V4.1 Flash. Bramka AI kieruje żądania wyłącznie do dostawców z siedzibą w UE, z których wszyscy stosują zero data retention. Nie potrzebujesz kont u tych dostawców: Codex wysyła wszystkie żądania z Twoim kluczem API Nodion.
Ten poradnik opiera się na dokumentacji Codex dla wydania 0.165.0 (październik 2026).
Czego potrzebujesz
- Konta Nodion i projektu z AI Inference.
- Klucza API: klucza do inferencji z AI Inference → Keys (zaczyna się od
nodion_ai_i jest wyświetlany tylko raz) albo klucza utworzonego w ramach Twojego AI Coding Plan. Klucze do API platformy Nodion tutaj nie działają. - Środków na saldzie przedpłaconym, chyba że korzystasz z klucza przypisanego do AI Coding Plan.
- Codex CLI. Pliki profili opisane niżej wymagają wersji 0.134.0 lub nowszej.
Ustaw klucz w powłoce, w której uruchamiasz Codex:
export NODION_AI_KEY=nodion_ai_your_keyDodaj Nodion jako własnego dostawcę
Otwórz ~/.codex/config.toml i dodaj:
# ~/.codex/config.toml
model = "moonshot/kimi-k3"
model_provider = "nodion"

[model_providers.nodion]
name = "Nodion"
base_url = "https://api.nodion.ai/v1"
env_key = "NODION_AI_KEY"
wire_api = "responses"modelto identyfikator modelu z katalogu Nodion, razem z ukośnikiem.model_providerwybiera blok poniżej. Identyfikatoryopenai,ollamailmstudiosą zarezerwowane, więc dostawca potrzebuje własnego identyfikatora.env_keywskazuje zmienną środowiskową z kluczem. Własni dostawcy pomijają logowanie do OpenAI, chyba że ustawiszrequires_openai_auth.wire_api = "responses"to jedyna wartość, którą Codex akceptuje, i zarazem wartość domyślna. Codex odrzuca starsze konfiguracje zwire_api = "chat"przy ich wczytywaniu:`wire_api = "chat"` is no longer supported.
Źródła, sprawdzone w październiku 2026: dokumentacja referencyjna konfiguracji Codex, dyskusja #7782, model-provider-info.
Wybierz model
Trzy modele czatu dostępne w AI Coding Plans, wszystkie z obsługą narzędzi (tools) i rozumowania (reasoning):
| Model | Identyfikator | Wejście | Kontekst (katalog) | Maks. wyjście |
|---|---|---|---|---|
| Kimi K3 | moonshot/kimi-k3 | Tekst, obraz, wideo | 1 048 576 | 32 768 |
| GLM 5.3 | z-ai/glm-5.3 | Tekst | 1 048 576 | 131 072 |
| DeepSeek V4.1 Flash | deepseek/deepseek-v4.1-flash | Tekst, obraz | 1 048 576 | 393 216 |
Na czas jednej sesji zmienisz model za pomocą -m (--model); dostawca pozostanie ten z Twojej konfiguracji:
codex -m z-ai/glm-5.3
codex -m deepseek/deepseek-v4.1-flash
Profile to teraz osobne pliki
Od wersji Codex 0.134.0 --profile nie odczytuje już tabel [profiles.name] z config.toml. Każdy profil to osobny plik, ~/.codex/<name>.config.toml, z kluczami najwyższego poziomu, które Codex nakłada na Twoją konfigurację bazową. Zostaw blok dostawcy w config.toml i utwórz osobny profil dla każdego modelu:
# ~/.codex/nodion-glm.config.toml
model = "z-ai/glm-5.3"
model_provider = "nodion"
codex --profile nodion-glm
codex exec --profile nodion-glm "Summarize the open TODOs in this repo"Konfiguracja projektu nie ustawi dostawcy
W zaufanych projektach Codex odczytuje plik .codex/config.toml wewnątrz repozytorium, ale ignoruje w nim model_provider i model_providers oraz wyświetla ostrzeżenie przy starcie. Blok dostawcy umieść więc w ~/.codex/config.toml albo w pliku profilu. Jeśli Twoje ustawienia nie działają, /debug-config pokaże, które warstwy konfiguracji Codex wczytał.
Źródła: zaawansowana konfiguracja Codex, podstawy konfiguracji Codex, polecenia slash.
Uwaga na okno kontekstu
Codex nie ma wbudowanych metadanych dla tych identyfikatorów modeli. Wyświetla Unknown model moonshot/kimi-k3 is used. This will use fallback model metadata. i pracuje z oknem kontekstu 272 000 tokenów. model_context_window może obniżyć tę wartość, ale nie może jej podnieść. W Codex dostępne okno kontekstu pozostaje więc mniejsze niż 1 048 576 tokenów, które katalog podaje dla wszystkich trzech modeli. Samo ostrzeżenie jest normalne.
Źródło: model_info.rs w repozytorium Codex.
Sprawdź konfigurację
Uruchom codex w repozytorium i wpisz /status. Polecenie pokazuje konfigurację sesji: aktywny model, zasady zatwierdzania działań (approval policy), katalogi z prawem zapisu i pozostały kontekst. To jeszcze nie dowodzi, że żądanie się powiodło, więc wyślij pierwszy prompt, na przykład „Wyjaśnij w dwóch zdaniach, co robi to repozytorium”. Jeśli dostaniesz odpowiedź, klucz, bazowy URL i identyfikator modelu działają. Zakładki Usage i Requests w AI Inference pokazują ruch.
Co w praktyce oznacza bezstanowe /v1/responses
- Nic nie jest zapisywane. Nodion nie przechowuje żadnych odpowiedzi:
storejest ignorowane, a odpowiedź zawierastore: false. Nie maprevious_response_id,conversationaniGET /v1/responses/{id}. Codex przy każdym żądaniu wysyła całą rozmowę winput, więc ich nie potrzebuje. - Długie sesje kosztują więcej z każdą turą. Każde żądanie zawiera całą dotychczasową rozmowę, więc liczba tokenów wejściowych rośnie wraz z sesją. Tokeny wejściowe z cache są rozliczane po stawce dla cache, jeśli trasa to raportuje.
- Wyszukiwanie w sieci działa. Bramka AI sama wykonuje
web_searchprzez wyszukiwanie w sieci Nodion i zwraca zapytanie oraz adresy URL źródeł w elemencieweb_search_call. Wyszukiwanie zwraca trafienia z indeksu (tytuł, URL, fragment) i nie otwiera żadnych stron. Domyślnie wykonuje najwyżej 10 wyszukiwań na odpowiedź (max_tool_calls, do 20). - Narzędzia:
function,custom,namespaceiweb_search. Inne narzędzia hostowane są odrzucane. - Wyniki narzędzi to tekst. Obrazy i pliki w wynikach narzędzi nie trafiają do modelu; zastępuje je notatka w tekście.
Rozliczenia: saldo czy AI Coding Plan
Użycie klucza nieprzypisanego do planu jest opłacane z salda przedpłaconego: tokeny wejściowe i wyjściowe według ceny modelu. Każde wyszukiwanie w sieci jest rozliczane jak wywołanie narzędzia do wyszukiwania w sieci, a każda tura modelu jak chat completion. Klucz przypisany do AI Coding Plan (Go, Pro lub Max) korzysta zamiast tego z limitu użycia czatu i narzędzi zawartego w planie. Użycie liczy się do limitów 5-godzinnego, tygodniowego i miesięcznego. Gdy któryś zostanie wyczerpany, żądania są dalej obsługiwane z salda tylko wtedy, gdy plan dopuszcza korzystanie z salda. Ceny poszczególnych modeli znajdziesz na stronach modeli w AI Inference, a plany na stronie AI Coding Plans.
Rozwiązywanie problemów
- 401: brakuje klucza albo ma on niewłaściwy typ. Klucze platformy (
nodion_…) nie działają z tym API. Użyj klucza do inferencji (nodion_ai_…) albo klucza z Twojego planu i sprawdź, czy zmiennaNODION_AI_KEYjest wyeksportowana w powłoce, która uruchamia Codex. - 400 dla narzędzia: narzędzia hostowane inne niż
web_search, np.file_searchczycode_interpreter, są odrzucane z kodem 400. Tak samobackground,prompt,truncation: "auto",file_idifile_url. - 404
model not found: identyfikator modelu jest błędny.curl https://api.nodion.ai/v1/modelswyświetla dokładne identyfikatory i nie wymaga klucza. - 402: saldo nie pokrywa żądania albo osiągnięto limit wydatków. Doładuj saldo w zakładce Billing albo sprawdź dzienny limit klucza.
- 503: żadna sprawna trasa dla modelu nie pasuje do ustawień AI projektu, na przykład dlatego, że jego dostawcy są tam wykluczeni.
Źródła: Dokumentacja API AI: Responses API, błędy i limity, dokumentacja AI Inference, AI Coding Plans.
Dalsze kroki
- Wszystkie pola Responses API w Nodion: Dokumentacja API AI.
- Wolisz OpenCode? OpenCode z Kimi K3 i GLM 5.3. Dla Aider, Cline i Continue: Aider, Cline i Continue z modelami z UE.
- Miesięczny pakiet dla agentów AI do kodowania: AI Coding Plans.
Najczęściej zadawane pytania
Czy Codex CLI może korzystać z modeli innych niż OpenAI?
Tak. Codex obsługuje własnych dostawców, którzy udostępniają OpenAI Responses API. Z blokiem model_providers dla https://api.nodion.ai/v1 działa z Kimi K3, GLM 5.3 lub DeepSeek V4.1 Flash przez Nodion AI Gateway, który kieruje żądania wyłącznie do dostawców z siedzibą w UE.
Czy Codex CLI nadal obsługuje wire_api = "chat"?
Nie. Codex odrzuca wire_api = "chat" przy wczytywaniu konfiguracji. "responses" to jedyna obsługiwana wartość i zarazem domyślna, więc własny dostawca musi udostępniać Responses API.
Dlaczego okno kontekstu w Codex jest mniejsze niż okno modelu?
Codex nie ma metadanych dla nieznanych mu identyfikatorów modeli i przyjmuje domyślne okno 272 000 tokenów. Ustawienie model_context_window może obniżyć tę wartość, ale nie może jej podnieść.
Czy mogę płacić za użycie Codex w ramach AI Coding Plan?
Tak. Klucz utworzony w ramach AI Coding Plan od Nodion korzysta z użycia zawartego w planie dla czatu i narzędzi, liczonego w oknach 5-godzinnym, tygodniowym i miesięcznym. Klucze bez planu płacą z salda przedpłaconego.