Codex CLI mit EU-Modellen: Kimi K3, GLM 5.3 und DeepSeek V4.1 Flash über einen eigenen Provider
 Niklas KarolyFounder Nodion
Kurz gesagt
- Codex CLI läuft mit einem eigenen Provider in
~/.codex/config.tomlgegen das Nodion AI Gateway: Base-URLhttps://api.nodion.ai/v1,env_key = "NODION_AI_KEY"undwire_api = "responses", die einzige Wire-API, die Codex noch akzeptiert. - Das Gateway routet nur zu Providern mit Sitz in der EU, die alle mit Zero Data Retention ausliefern, und Codex ruft Kimi K3, GLM 5.3 und DeepSeek V4.1 Flash mit deinem Nodion-API-Key auf, ohne Konto bei den Providern.
- Codex kennt diese Model-IDs nicht und nutzt ein Fallback-Kontextfenster von 272.000 Tokens, weniger als der Katalogwert; seit Codex 0.134.0 ist jedes Profil eine eigene Datei in ~/.codex, und eine Projekt-.codex/config.toml kann den Provider nicht setzen.
- Nodions
/v1/responsesist zustandslos: Codex schickt mit jedem Request den ganzen Verlauf, Websuche funktioniert und keine Response wird gespeichert; Details in der AI-API-Referenz.
Codex CLI spricht mit jedem Provider, der die OpenAI Responses API bedient. Das Nodion AI Gateway unter https://api.nodion.ai/v1 bietet /v1/responses, also reicht ein Provider-Block in ~/.codex/config.toml, um Codex mit Kimi K3, GLM 5.3 oder DeepSeek V4.1 Flash zu nutzen. Das Gateway routet nur zu Providern mit Sitz in der EU, die alle mit Zero Data Retention ausliefern. Ein Konto bei diesen Providern brauchst du nicht: Codex ruft alles mit deinem Nodion-API-Key auf.
Die Anleitung folgt der Codex-Dokumentation zum Release 0.165.0 (Oktober 2026).
Was du brauchst
- Ein Nodion-Konto und ein Projekt mit AI Inference.
- Einen API-Key: einen Inference-Key aus AI Inference → Keys (er beginnt mit
nodion_ai_und wird einmal angezeigt) oder einen Key, den du auf deinem AI Coding Plan anlegst. Keys für die Nodion-Plattform-API funktionieren hier nicht. - Guthaben im Prepaid-Wallet, außer der Key liegt auf einem Coding Plan.
- Codex CLI. Die Profil-Dateien weiter unten brauchen 0.134.0 oder neuer.
Setz den Key in der Shell, in der Codex läuft:
export NODION_AI_KEY=nodion_ai_dein_keyNodion als eigenen Provider eintragen
Öffne ~/.codex/config.toml und ergänze:
# ~/.codex/config.toml
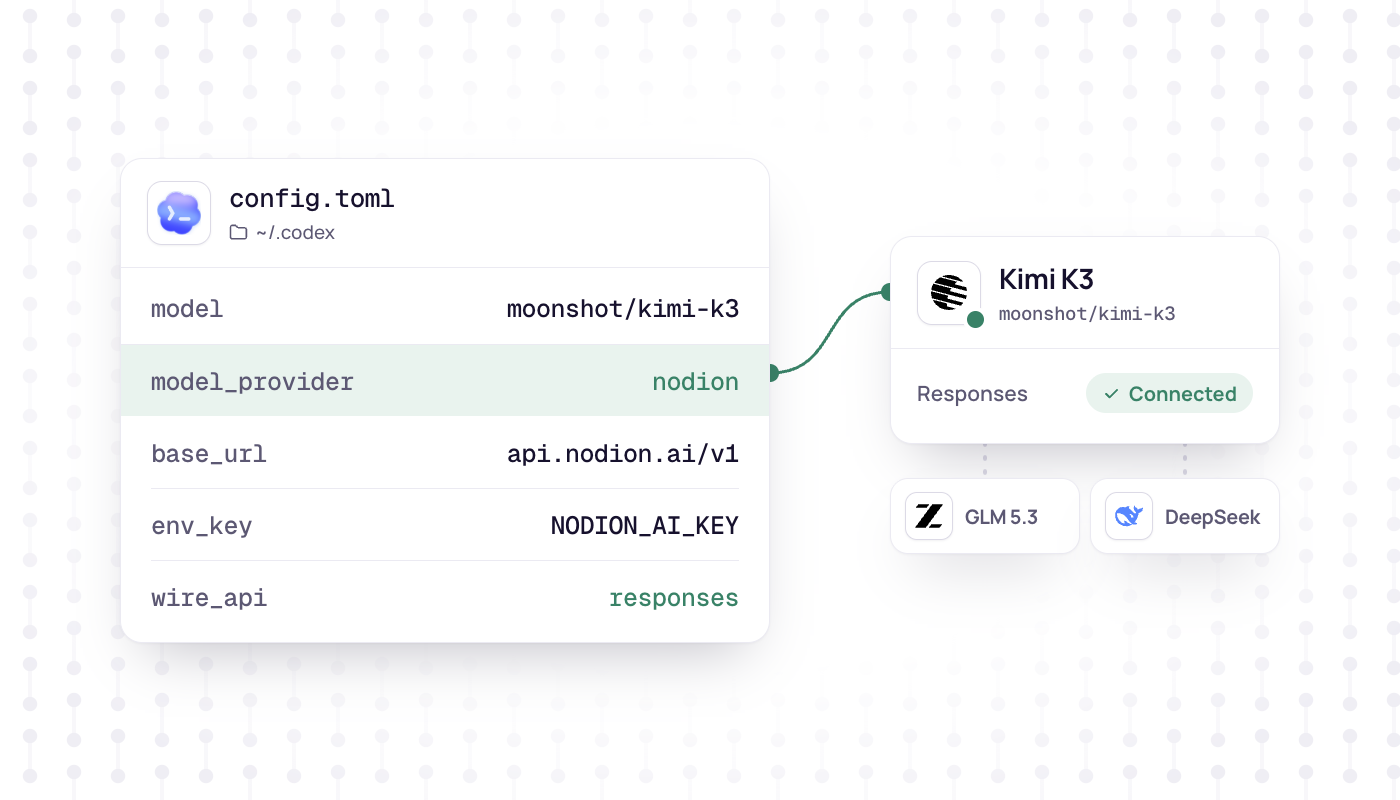
model = "moonshot/kimi-k3"
model_provider = "nodion"

[model_providers.nodion]
name = "Nodion"
base_url = "https://api.nodion.ai/v1"
env_key = "NODION_AI_KEY"
wire_api = "responses"modelist die Model-ID aus dem Nodion-Katalog, mit Schrägstrich.model_providerwählt den Block darunter aus. Die IDsopenai,ollamaundlmstudiosind reserviert, der Provider braucht also eine eigene ID.env_keynennt die Umgebungsvariable mit dem Key. Eigene Provider überspringen den OpenAI-Login, solange durequires_openai_authnicht setzt.wire_api = "responses"ist der einzige Wert, den Codex akzeptiert, und der Standard. Alte Configs mitwire_api = "chat"lehnt Codex beim Einlesen ab:`wire_api = "chat"` is no longer supported.
Quellen, geprüft im Oktober 2026: Codex Config-Referenz, Diskussion #7782, model-provider-info.
Ein Modell wählen
Drei Chat-Modelle aus der Liste der AI Coding Plans, alle mit Tools und Reasoning:
| Modell | ID | Input | Kontext (Katalog) | Max. Output |
|---|---|---|---|---|
| Kimi K3 | moonshot/kimi-k3 | Text, Bild, Video | 1.048.576 | 32.768 |
| GLM 5.3 | z-ai/glm-5.3 | Text | 1.048.576 | 131.072 |
| DeepSeek V4.1 Flash | deepseek/deepseek-v4.1-flash | Text, Bild | 1.048.576 | 393.216 |
Für eine Session wechselst du mit -m (--model), der Provider bleibt der aus deiner Config:
codex -m z-ai/glm-5.3
codex -m deepseek/deepseek-v4.1-flash
Profile sind jetzt eigene Dateien
Seit Codex 0.134.0 liest --profile keine [profiles.name]-Tabellen mehr aus config.toml. Jedes Profil ist eine eigene Datei, ~/.codex/<name>.config.toml, mit Keys auf oberster Ebene, die Codex über deine Basis-Config legt. Lass den Provider-Block in config.toml und leg pro Modell ein Profil an:
# ~/.codex/nodion-glm.config.toml
model = "z-ai/glm-5.3"
model_provider = "nodion"
codex --profile nodion-glm
codex exec --profile nodion-glm "Fasse die offenen TODOs in diesem Repo zusammen"Projekt-Configs können den Provider nicht setzen
Eine .codex/config.toml im Repository liest Codex für vertrauenswürdige Projekte, ignoriert dort aber model_provider und model_providers und zeigt beim Start eine Warnung. Der Provider-Block gehört also in ~/.codex/config.toml oder in eine Profil-Datei. Wirken deine Settings nicht, zeigt /debug-config, welche Config-Ebenen Codex geladen hat.
Quellen: Codex Advanced Config, Codex Config Basics, Slash-Commands.
Der Haken beim Kontextfenster
Codex hat keine eingebauten Metadaten für diese Model-IDs. Es meldet Unknown model moonshot/kimi-k3 is used. This will use fallback model metadata. und rechnet mit einem Kontextfenster von 272.000 Tokens. model_context_window kann diesen Wert senken, aber nicht anheben. In Codex bleibt der nutzbare Kontext also unter den 1.048.576 Tokens, die der Katalog für alle drei Modelle nennt. Die Warnung selbst ist erwartbar.
Quelle: model_info.rs im Codex-Repository.
Das Setup prüfen
Starte codex in einem Repository und führe /status aus. Das zeigt die Session-Konfiguration: aktives Modell, Approval Policy, beschreibbare Pfade und verbleibenden Kontext. Das beweist nicht, dass ein Call durchgeht, schick deshalb einen ersten Prompt, zum Beispiel „Erklär in zwei Sätzen, was dieses Repository macht.“ Kommt eine Antwort, passen Key, Base-URL und Model-ID. In AI Inference siehst du den Traffic in den Tabs Usage und Requests.
Was ein zustandsloses /v1/responses praktisch bedeutet
- Nichts wird gespeichert. Nodion speichert keine Responses:
storewird ignoriert, die Antwort meldetstore: false.previous_response_id,conversationundGET /v1/responses/{id}gibt es nicht. Codex schickt mit jedem Request den ganzen Verlauf ininputund kommt ohne sie aus. - Lange Sessions kosten pro Runde mehr. Jeder Request trägt den bisherigen Verlauf, die Input-Tokens wachsen also mit der Session. Gecachter Input wird zum Cache-Preis abgerechnet, wenn die Route ihn meldet.
- Websuche funktioniert. Das Gateway führt
web_searchselbst über die Nodion-Websuche aus und liefert Query und Quell-URLs in einem Itemweb_search_call. Die Suche gibt Treffer aus dem Index zurück (Titel, URL, Snippet) und öffnet keine Seiten. Standardmäßig höchstens 10 Suchen pro Response (max_tool_calls, maximal 20). - Tools:
function,custom,namespaceundweb_search. Andere gehostete Tools lehnt das Gateway ab. - Tool-Outputs sind Text. Bilder und Dateien in Tool-Outputs erreichen das Modell nicht, ein Hinweis im Text ersetzt sie.
Abrechnung: Wallet oder Coding Plan
Ein Key ohne Plan zahlt aus dem Prepaid-Wallet: Input- und Output-Tokens zum Preis des Modells. Jede Websuche wird wie ein Call des Web-Search-Tools abgerechnet, jede Modellrunde wie eine Chat Completion. Ein Key auf einem AI Coding Plan (Go, Pro oder Max) nutzt stattdessen die enthaltene Nutzung des Plans für Chat und Tools. Sie zählt gegen ein 5-Stunden-, ein Wochen- und ein Monatsfenster. Ist eines voll, laufen Requests nur dann aus dem Wallet weiter, wenn der Plan Wallet-Nutzung erlaubt. Preise pro Modell stehen auf den Modellseiten unter AI Inference, die Pläne unter AI Coding Plans.
Fehlersuche
- 401: der Key fehlt oder hat den falschen Typ. Plattform-Keys (
nodion_…) funktionieren auf dieser API nicht. Nimm einen Inference-Key (nodion_ai_…) oder einen Key von deinem Coding Plan und prüf, dassNODION_AI_KEYin der Shell exportiert ist, die Codex startet. - 400 bei einem Tool: gehostete Tools außer
web_search, etwafile_searchodercode_interpreter, lehnt das Gateway mit 400 ab. Ebensobackground,prompt,truncation: "auto",file_idundfile_url. - 404
model not found: die Model-ID stimmt nicht.curl https://api.nodion.ai/v1/modelslistet die genauen IDs und braucht keinen Key. - 402: das Wallet deckt den Request nicht, oder ein Spend-Limit ist erreicht. Lade im Tab Billing auf oder prüf das Tageslimit des Keys.
- 503: keine gesunde Route für das Modell passt zu den AI-Settings des Projekts, etwa weil seine Provider dort ausgeschlossen sind.
Quellen: AI-API-Referenz: Responses API, Fehler und Limits, AI-Inference-Docs, AI Coding Plans.
Weiter geht's
- Alle Felder der Responses API auf Nodion: AI-API-Referenz.
- Lieber OpenCode? OpenCode mit Kimi K3 und GLM 5.3. Für Aider, Cline und Continue: Aider, Cline und Continue mit EU-Modellen.
- Ein Monatspaket für Coding-Agenten: AI Coding Plans.
Häufige Fragen
Kann Codex CLI andere Modelle als die von OpenAI nutzen?
Ja. Codex unterstützt eigene Provider, die die OpenAI Responses API bedienen. Mit einem model_providers-Block für https://api.nodion.ai/v1 läuft es mit Kimi K3, GLM 5.3 oder DeepSeek V4.1 Flash über das Nodion AI Gateway, das nur zu Providern mit Sitz in der EU routet.
Unterstützt Codex CLI noch wire_api = "chat"?
Nein. Codex lehnt wire_api = "chat" beim Einlesen der Config ab. "responses" ist der einzige unterstützte Wert und der Standard, ein eigener Provider muss also die Responses API bedienen.
Warum ist das Kontextfenster in Codex kleiner als das des Modells?
Codex hat für unbekannte Model-IDs keine Metadaten und nutzt ein Fallback-Fenster von 272.000 Tokens. Die Einstellung model_context_window kann diesen Wert senken, aber nicht anheben.
Kann ich die Codex-Nutzung über einen AI Coding Plan bezahlen?
Ja. Ein Key, den du auf einem Nodion AI Coding Plan anlegst, nutzt die enthaltene Nutzung des Plans für Chat und Tools, mit 5-Stunden-, Wochen- und Monatsfenster. Keys ohne Plan zahlen aus dem Prepaid-Wallet.