
Codex CLI con modelli UE: Kimi K3, GLM 5.3 e DeepSeek V4.1 Flash tramite un provider personalizzato
 Niklas KarolyFondatore di Nodion
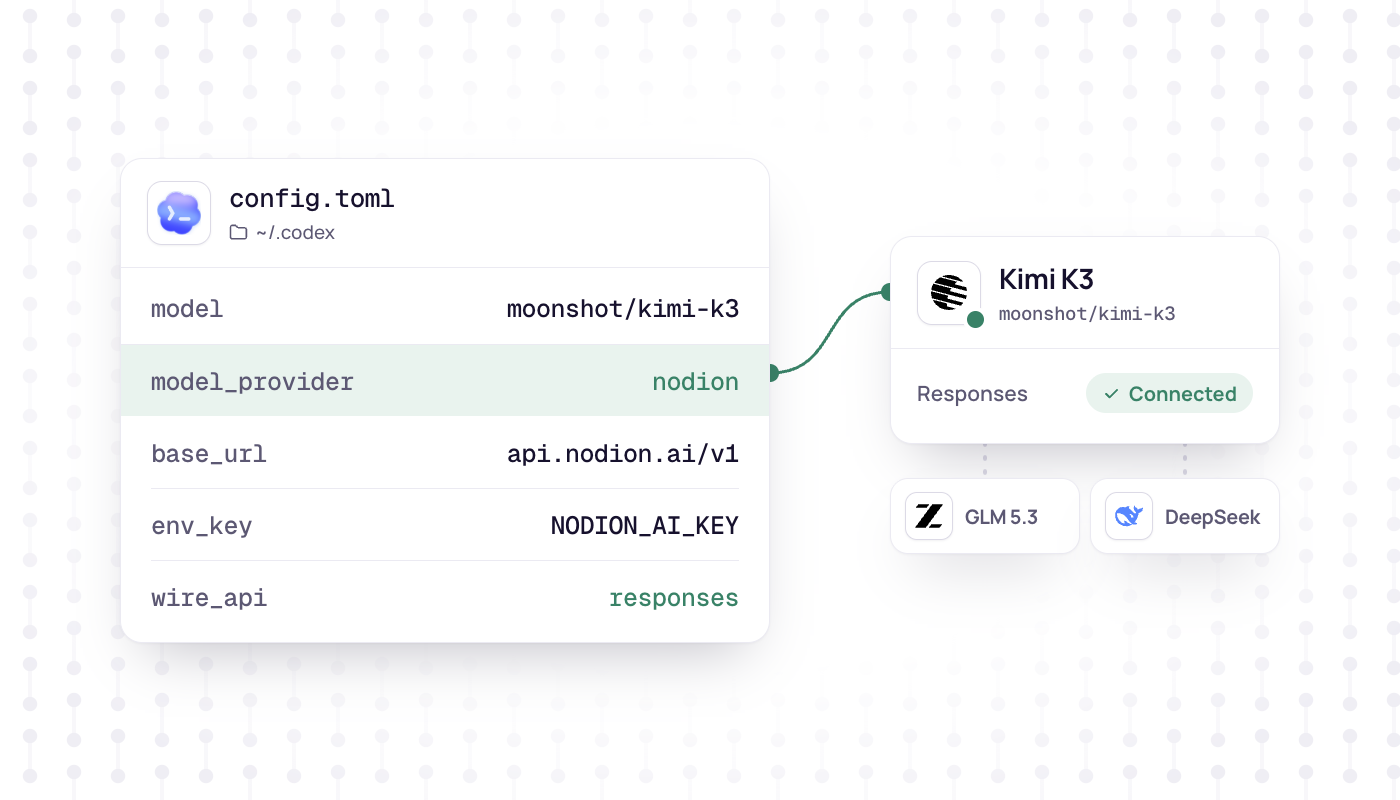
In breve
- Codex CLI funziona con l'AI Gateway di Nodion grazie a un provider personalizzato in
~/.codex/config.toml: base URLhttps://api.nodion.ai/v1,env_key = "NODION_AI_KEY"ewire_api = "responses", l'unica wire API che Codex accetta ancora. - Il gateway instrada solo verso provider con sede nell'UE, che servono tutti con zero data retention, e Codex chiama Kimi K3, GLM 5.3 e DeepSeek V4.1 Flash con la tua chiave API di Nodion, senza un account presso i provider.
- Codex non conosce questi id di modello e ripiega su una finestra di contesto di 272.000 token, inferiore al valore del catalogo; da Codex 0.134.0 ogni profilo è un file separato in ~/.codex, e un .codex/config.toml di progetto non può impostare il provider.
- Il
/v1/responsesdi Nodion è stateless: Codex invia l'intera conversazione a ogni richiesta, la ricerca web funziona e nessuna risposta viene salvata; i dettagli sono nel riferimento dell'API AI.
Codex CLI può usare qualsiasi provider che supporti la OpenAI Responses API. L'AI Gateway di Nodion su https://api.nodion.ai/v1 offre /v1/responses, quindi basta un blocco di configurazione del provider in ~/.codex/config.toml per usare Codex con Kimi K3, GLM 5.3 o DeepSeek V4.1 Flash. Il gateway instrada solo verso provider con sede nell'UE, tutti con zero data retention. Non ti serve un account presso quei provider: Codex chiama tutto con la tua chiave API di Nodion.
Questa guida segue la documentazione di Codex aggiornata alla release 0.165.0 (ottobre 2026).
Cosa ti serve
- Un account Nodion e un progetto con AI Inference.
- Una chiave API: una chiave di inferenza da AI Inference → Keys (inizia con
nodion_ai_e viene mostrata una sola volta), oppure una chiave che crei sul tuo AI Coding Plan. Le chiavi per l'API della piattaforma Nodion qui non funzionano. - Credito prepagato, a meno che la chiave non sia associata a un AI Coding Plan.
- Codex CLI. I file di profilo più avanti richiedono la 0.134.0 o successiva.
Imposta la chiave nella shell in cui gira Codex:
export NODION_AI_KEY=nodion_ai_your_keyAggiungi Nodion come provider personalizzato
Apri ~/.codex/config.toml e aggiungi:
# ~/.codex/config.toml
model = "moonshot/kimi-k3"
model_provider = "nodion"

[model_providers.nodion]
name = "Nodion"
base_url = "https://api.nodion.ai/v1"
env_key = "NODION_AI_KEY"
wire_api = "responses"modelè l'ID del modello nel catalogo Nodion, barra inclusa.model_providerseleziona il blocco sottostante. Gli IDopenai,ollamaelmstudiosono riservati, quindi il provider ha bisogno di un ID proprio.env_keyindica la variabile d'ambiente che contiene la chiave. I provider personalizzati non richiedono il login OpenAI, a meno che tu non impostirequires_openai_auth.wire_api = "responses"è l'unico valore che Codex accetta, ed è quello predefinito. Codex rifiuta le configurazioni più vecchie conwire_api = "chat"quando le legge:`wire_api = "chat"` is no longer supported.
Fonti, verificate a ottobre 2026: riferimento della configurazione di Codex, discussione #7782, model-provider-info.
Scegli un modello
Tre modelli per la chat dall'elenco degli AI Coding Plans, tutti con supporto ai tool e al reasoning:
| Modello | ID | Input | Contesto (catalogo) | Output max |
|---|---|---|---|---|
| Kimi K3 | moonshot/kimi-k3 | Testo, immagini, video | 1.048.576 | 32.768 |
| GLM 5.3 | z-ai/glm-5.3 | Testo | 1.048.576 | 131.072 |
| DeepSeek V4.1 Flash | deepseek/deepseek-v4.1-flash | Testo, immagini | 1.048.576 | 393.216 |
Per cambiare modello in una sessione usa -m (--model); il provider resta quello della tua configurazione:
codex -m z-ai/glm-5.3
codex -m deepseek/deepseek-v4.1-flash
Ora i profili sono file separati
Da Codex 0.134.0, --profile non legge più le tabelle [profiles.name] da config.toml. Ogni profilo è un file separato, ~/.codex/<name>.config.toml, con chiavi di primo livello che Codex sovrappone alla tua configurazione di base. Lascia il blocco del provider in config.toml e crea un profilo per ogni modello:
# ~/.codex/nodion-glm.config.toml
model = "z-ai/glm-5.3"
model_provider = "nodion"
codex --profile nodion-glm
codex exec --profile nodion-glm "Summarize the open TODOs in this repo"Le configurazioni di progetto non possono impostare il provider
Per i progetti attendibili Codex legge un .codex/config.toml all'interno del repository, ma lì ignora model_provider e model_providers e mostra un avviso all'avvio. Il blocco del provider va quindi in ~/.codex/config.toml o in un file di profilo. Se le tue impostazioni sembrano non avere effetto, /debug-config mostra quali livelli di configurazione Codex ha caricato.
Fonti: configurazione avanzata di Codex, basi della configurazione di Codex, comandi slash.
Il limite della finestra di contesto
Codex non ha metadati integrati per questi ID di modello. Segnala Unknown model moonshot/kimi-k3 is used. This will use fallback model metadata. e usa una finestra di contesto di 272.000 token. model_context_window può abbassare questo valore ma non alzarlo. In Codex, quindi, il contesto utilizzabile resta sotto i 1.048.576 token che il catalogo indica per tutti e tre i modelli. Questo avviso è normale.
Fonte: model_info.rs nel repository di Codex.
Verifica la configurazione
Avvia codex in un repository ed esegui /status. Mostra la configurazione della sessione: il modello attivo, la policy di approvazione, le directory scrivibili e il contesto rimanente. Questo non conferma che una chiamata sia riuscita: invia quindi un primo prompt, ad esempio “Spiega in due frasi cosa fa questo repository.” Se arriva una risposta, la chiave, l'URL di base e l'ID del modello funzionano. Le schede Usage e Requests in AI Inference mostrano il traffico.
Cosa comporta in pratica un endpoint /v1/responses senza stato
- Non viene salvato nulla. Nodion non salva le risposte:
storeviene ignorato e la risposta riportastore: false. Non esistonoprevious_response_id,conversationnéGET /v1/responses/{id}. Codex invia l'intera conversazione ininputa ogni richiesta, quindi non ne ha bisogno. - Le sessioni lunghe costano di più a ogni turno. Ogni richiesta porta con sé la conversazione fin lì, quindi i token di input crescono con la sessione. L'input in cache viene fatturato al prezzo della cache quando la route lo riporta.
- La ricerca web funziona. Il gateway esegue
web_searchda sé tramite la ricerca web di Nodion e restituisce la query e gli URL delle fonti in un elementoweb_search_call. La ricerca restituisce risultati dall'indice (titolo, URL, snippet) e non apre pagine. Per impostazione predefinita al massimo 10 ricerche per risposta (max_tool_calls, fino a 20). - Tool:
function,custom,namespaceeweb_search. Gli altri tool ospitati vengono rifiutati. - Gli output dei tool sono testo. Immagini e file negli output dei tool non raggiungono il modello; una nota nel testo li sostituisce.
Fatturazione: credito prepagato o coding plan
Le richieste con una chiave non legata a un piano vengono addebitate al credito prepagato: token di input e di output al prezzo del modello. Ogni ricerca web viene fatturata come una chiamata al tool di ricerca web e ogni turno del modello come una chat completion. Una chiave su un AI Coding Plan (Go, Pro o Max) usa invece l'utilizzo incluso nel piano per chat e tool. Questo utilizzo viene conteggiato in una finestra di 5 ore, una settimanale e una mensile. Quando esaurisci il limite in una di queste finestre, le richieste continuano sul credito prepagato solo se il piano consente l'uso del credito. I prezzi per modello sono nelle pagine dei modelli sotto AI Inference, i piani su AI Coding Plans.
Risoluzione dei problemi
- 401: la chiave manca o è del tipo sbagliato. Le chiavi della piattaforma (
nodion_…) non funzionano su questa API. Usa una chiave di inferenza (nodion_ai_…) o una chiave del tuo coding plan, e verifica cheNODION_AI_KEYsia esportata nella shell che avvia Codex. - 400 per un tool: i tool ospitati diversi da
web_search, comefile_searchocode_interpreter, vengono rifiutati con 400. Lo stesso vale perbackground,prompt,truncation: "auto",file_idefile_url. - 404
model not found: l'ID del modello è errato.curl https://api.nodion.ai/v1/modelselenca gli ID esatti e non richiede una chiave. - 402: il credito non copre la richiesta, oppure è stato raggiunto un limite di spesa. Ricarica nella scheda Billing o controlla il limite giornaliero della chiave.
- 503: nessuna route funzionante per il modello è compatibile con le impostazioni AI del progetto, ad esempio perché lì i suoi provider sono esclusi.
Fonti: riferimento dell'API AI: Responses API, errori e limiti, documentazione di AI Inference, AI Coding Plans.
Prossimi passi
- Tutti i campi della Responses API su Nodion: riferimento dell'API AI.
- Preferisci OpenCode? OpenCode con Kimi K3 e GLM 5.3. Per Aider, Cline e Continue: Aider, Cline e Continue con modelli UE.
- Un pacchetto mensile per gli agenti di coding: AI Coding Plans.
Domande frequenti
Codex CLI può usare modelli diversi da quelli di OpenAI?
Sì. Codex supporta provider personalizzati che servono la OpenAI Responses API. Con un blocco model_providers per https://api.nodion.ai/v1 funziona con Kimi K3, GLM 5.3 o DeepSeek V4.1 Flash tramite l'AI Gateway di Nodion, che instrada solo verso provider con sede nell'UE.
Codex CLI supporta ancora wire_api = "chat"?
No. Codex rifiuta wire_api = "chat" quando legge la configurazione. "responses" è l'unico valore supportato ed è quello predefinito, quindi un provider personalizzato deve servire la Responses API.
Perché in Codex la finestra di contesto è più piccola di quella del modello?
Codex non ha metadati per gli id di modello che non conosce e ripiega su una finestra di 272.000 token. L'impostazione model_context_window può abbassare questo valore ma non alzarlo.
Posso pagare l'uso di Codex con un AI Coding Plan?
Sì. Una chiave creata su un AI Coding Plan di Nodion usa l'utilizzo incluso nel piano per chat e tool, conteggiato su finestre di 5 ore, settimanali e mensili. Le chiavi senza piano pagano dal credito prepagato.