
Codex CLI met EU-modellen: Kimi K3, GLM 5.3 en DeepSeek V4.1 Flash via een zelf ingestelde aanbieder
 Niklas KarolyOprichter van Nodion
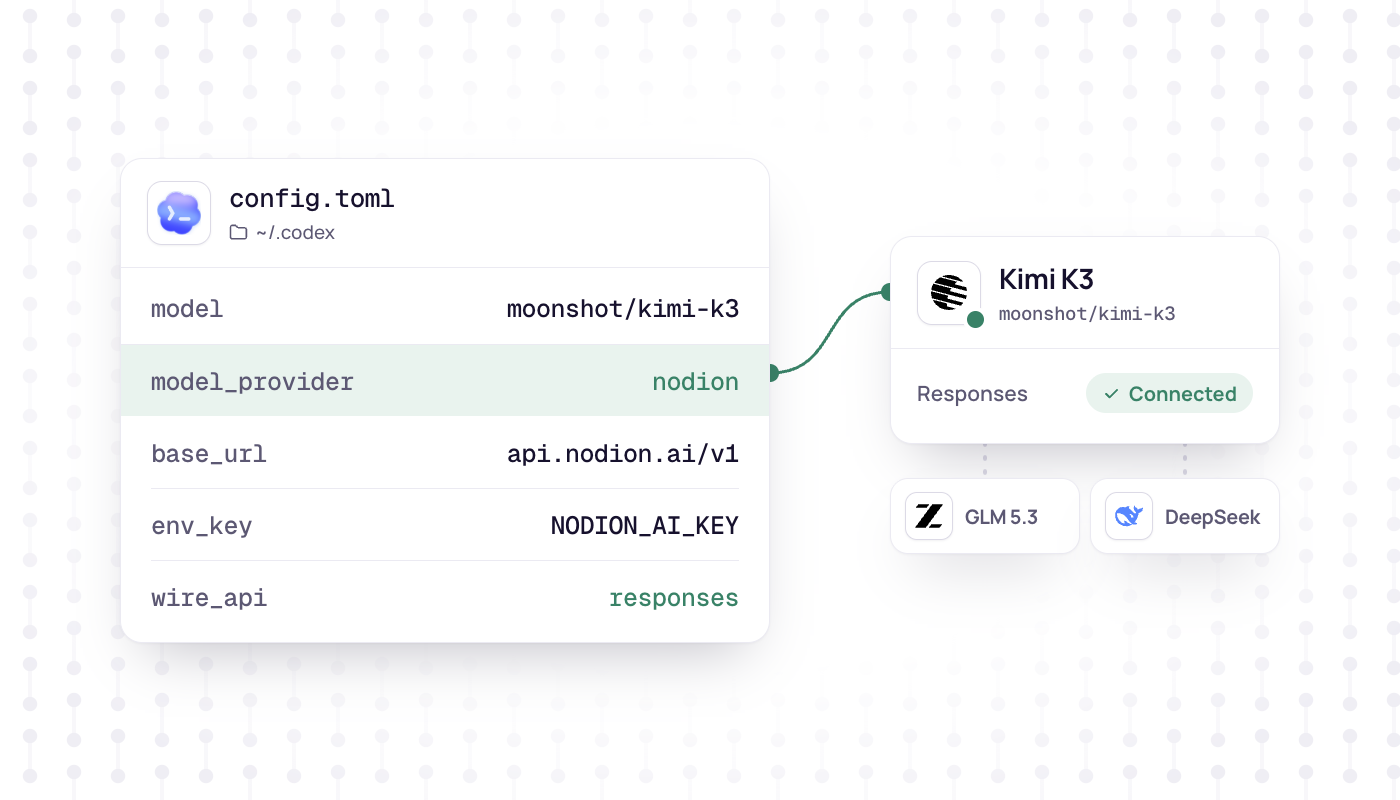
In het kort
- Codex CLI gebruikt de Nodion AI Gateway via een zelf ingestelde aanbieder in
~/.codex/config.toml: base-URLhttps://api.nodion.ai/v1,env_key = "NODION_AI_KEY"enwire_api = "responses", de enige wire API die Codex nog accepteert. - De gateway routeert alleen naar aanbieders die in de EU gevestigd zijn, allemaal met zero data retention, en Codex roept Kimi K3, GLM 5.3 en DeepSeek V4.1 Flash aan met je API-sleutel van Nodion, zonder account bij de aanbieders.
- Codex kent deze model-ID's niet en valt terug op een contextvenster van 272.000 tokens, onder de waarde uit de catalogus; sinds Codex 0.134.0 is elk profiel een apart bestand in ~/.codex, en een .codex/config.toml in een project kan de aanbieder niet instellen.
- De
/v1/responsesvan Nodion is stateless: Codex stuurt bij elk request het hele gesprek mee, webzoeken werkt en er wordt geen response opgeslagen; details staan in de AI-API-referentie.
Codex CLI kan werken met elke aanbieder die de OpenAI Responses API aanbiedt. De Nodion AI Gateway op https://api.nodion.ai/v1 biedt /v1/responses, dus één configuratieblok voor Nodion in ~/.codex/config.toml is genoeg om Codex te draaien met Kimi K3, GLM 5.3 of DeepSeek V4.1 Flash. De gateway routeert alleen naar aanbieders die in de EU gevestigd zijn, allemaal met zero data retention. Je hebt geen account bij die aanbieders nodig: Codex roept alles aan met je API-sleutel van Nodion.
Deze handleiding volgt de Codex-documentatie van release 0.165.0 (oktober 2026).
Wat je nodig hebt
- Een Nodion-account en een project met AI Inference.
- Een API-sleutel: een inference-sleutel uit AI Inference → Keys (begint met
nodion_ai_en wordt maar één keer getoond), of een sleutel die je op je AI Coding Plan aanmaakt. Sleutels voor de API van het Nodion-platform werken hier niet. - Prepaid tegoed, tenzij de sleutel bij een AI Coding Plan hoort.
- Codex CLI. De profielbestanden verderop vereisen 0.134.0 of nieuwer.
Zet de sleutel in de shell waarin Codex draait:
export NODION_AI_KEY=nodion_ai_your_keyNodion toevoegen als eigen aanbieder
Open ~/.codex/config.toml en voeg toe:
# ~/.codex/config.toml
model = "moonshot/kimi-k3"
model_provider = "nodion"

[model_providers.nodion]
name = "Nodion"
base_url = "https://api.nodion.ai/v1"
env_key = "NODION_AI_KEY"
wire_api = "responses"modelis de model-id uit de Nodion-catalogus, inclusief de slash.model_providerselecteert het blok hieronder. De id'sopenai,ollamaenlmstudiozijn gereserveerd, dus de aanbieder heeft een eigen id nodig.env_keynoemt de omgevingsvariabele met de sleutel. Eigen aanbieders slaan de OpenAI-login over, tenzij jerequires_openai_authinstelt.wire_api = "responses"is de enige waarde die Codex accepteert, en ook de standaardwaarde. Codex weigert oudere configs metwire_api = "chat"zodra het ze inleest:`wire_api = "chat"` is no longer supported.
Bronnen, gecontroleerd in oktober 2026: Codex-configuratiereferentie, discussie #7782, model-provider-info.
Een model kiezen
Drie chatmodellen uit de lijst van AI Coding Plans, allemaal met tools en reasoning:
| Model | Id | Invoer | Context (catalogus) | Max. uitvoer |
|---|---|---|---|---|
| Kimi K3 | moonshot/kimi-k3 | Tekst, afbeelding, video | 1.048.576 | 32.768 |
| GLM 5.3 | z-ai/glm-5.3 | Tekst | 1.048.576 | 131.072 |
| DeepSeek V4.1 Flash | deepseek/deepseek-v4.1-flash | Tekst, afbeelding | 1.048.576 | 393.216 |
Wissel voor één sessie van model met -m (--model); de aanbieder blijft die uit je configuratie:
codex -m z-ai/glm-5.3
codex -m deepseek/deepseek-v4.1-flash
Profielen zijn nu aparte bestanden
Sinds Codex 0.134.0 leest --profile geen tabellen [profiles.name] meer uit config.toml. Elk profiel is een eigen bestand, ~/.codex/<name>.config.toml, met keys op het hoogste niveau die Codex over je basisconfig heen legt. Houd het providerblok in config.toml en maak één profiel per model:
# ~/.codex/nodion-glm.config.toml
model = "z-ai/glm-5.3"
model_provider = "nodion"
codex --profile nodion-glm
codex exec --profile nodion-glm "Summarize the open TODOs in this repo"Projectconfiguraties kunnen de aanbieder niet instellen
Codex leest voor vertrouwde projecten een .codex/config.toml in een repository, maar negeert daarin model_provider en model_providers en toont bij het opstarten een waarschuwing. Het configuratieblok voor de aanbieder hoort dus in ~/.codex/config.toml of in een profielbestand. Lijken je instellingen geen effect te hebben, dan laat /debug-config zien welke configuratielagen Codex heeft geladen.
Bronnen: geavanceerde Codex-configuratie, basisconfiguratie van Codex, slash-commando's.
Let op het contextvenster
Codex heeft geen ingebouwde metadata voor deze model-id's. Het meldt Unknown model moonshot/kimi-k3 is used. This will use fallback model metadata. en werkt met een contextvenster van 272.000 tokens. model_context_window kan die waarde verlagen, maar niet verhogen. In Codex blijft de bruikbare context dus onder de 1.048.576 tokens die de catalogus voor alle drie de modellen noemt. De waarschuwing zelf is normaal.
Bron: model_info.rs in de Codex-repository.
De configuratie controleren
Start codex in een repository en voer /status uit. Je ziet dan de sessieconfiguratie: het actieve model, het goedkeuringsbeleid (approval policy), de schrijfbare mappen en de resterende context. Dat bewijst nog niet dat een call is doorgekomen, dus stuur een eerste prompt, bijvoorbeeld “Leg in twee zinnen uit wat deze repository doet.” Komt er een antwoord, dan werken de sleutel, de base URL en de model-id. De tabbladen Usage en Requests in AI Inference tonen het verkeer.
Wat een stateless /v1/responses in de praktijk betekent
- Er wordt niets opgeslagen. Nodion slaat geen responses op:
storewordt genegeerd en het antwoord meldtstore: false. Er is geenprevious_response_id,conversationofGET /v1/responses/{id}. Codex stuurt bij elk request het hele gesprek mee ininput, dus het heeft die niet nodig. - Lange sessies kosten meer per beurt. Elk request bevat het gesprek tot dan toe, dus het aantal input-tokens groeit met de sessie. Gecachete input wordt tegen de cacheprijs gefactureerd als de route dat rapporteert.
- Webzoeken werkt. De gateway voert
web_searchzelf uit via de webzoekfunctie van Nodion en geeft de zoekopdracht en de bron-URL's terug in een itemweb_search_call. De zoekfunctie geeft indexresultaten terug (titel, URL, fragment) en opent geen pagina's. Standaard maximaal 10 zoekopdrachten per response (max_tool_calls, tot 20). - Tools:
function,custom,namespaceenweb_search. Andere hosted tools worden geweigerd. - Tool-output is tekst. Afbeeldingen en bestanden in tool-output bereiken het model niet; een notitie in de tekst vervangt ze.
Facturering: tegoed of coding plan
Gebruik met een sleutel zonder plan wordt betaald uit het prepaid tegoed: input- en outputtokens tegen de prijs van het model. Elke webzoekopdracht wordt gefactureerd als een aanroep van de webzoektool, en elke modelronde als een chat completion. Een sleutel op een AI Coding Plan (Go, Pro of Max) gebruikt in plaats daarvan het inbegrepen gebruik van het plan voor chat en tools. Dat gebruik telt mee voor een venster van 5 uur, een weekvenster en een maandvenster. Is één van die limieten bereikt, dan lopen requests alleen door op het tegoed als het plan gebruik van het tegoed toestaat. Prijzen per model staan op de modelpagina's onder AI Inference, de plannen op AI Coding Plans.
Problemen oplossen
- 401: de sleutel ontbreekt of is van het verkeerde type. Platformsleutels (
nodion_…) werken niet op deze API. Gebruik een inference-sleutel (nodion_ai_…) of een sleutel van je coding plan, en controleer ofNODION_AI_KEYis geëxporteerd in de shell die Codex start. - 400 voor een tool: andere hosted tools dan
web_search, zoalsfile_searchofcode_interpreter, worden met 400 geweigerd. Dat geldt ook voorbackground,prompt,truncation: "auto",file_idenfile_url. - 404
model not found: de model-id klopt niet.curl https://api.nodion.ai/v1/modelstoont de exacte id's en heeft geen sleutel nodig. - 402: het tegoed dekt het request niet, of er is een uitgavelimiet bereikt. Vul je tegoed aan op het tabblad Billing of controleer de daglimiet van de sleutel.
- 503: geen gezonde route voor het model past bij de AI-instellingen van het project, bijvoorbeeld omdat de aanbieders ervan daar zijn uitgesloten.
Bronnen: AI-API-referentie: Responses API, fouten en limieten, documentatie van AI Inference, AI Coding Plans.
Volgende stappen
- Alle velden van de Responses API op Nodion: AI-API-referentie.
- Liever OpenCode? OpenCode met Kimi K3 en GLM 5.3. Voor Aider, Cline en Continue: Aider, Cline en Continue met EU-modellen.
- Een maandpakket voor coding agents: AI Coding Plans.
Veelgestelde vragen
Kan Codex CLI andere modellen gebruiken dan die van OpenAI?
Ja. Codex ondersteunt zelf ingestelde aanbieders die de OpenAI Responses API aanbieden. Met een model_providers-blok voor https://api.nodion.ai/v1 draait het met Kimi K3, GLM 5.3 of DeepSeek V4.1 Flash via de Nodion AI Gateway, die alleen naar aanbieders routeert die in de EU gevestigd zijn.
Ondersteunt Codex CLI nog wire_api = "chat"?
Nee. Codex weigert wire_api = "chat" bij het inlezen van de config. "responses" is de enige ondersteunde waarde en de standaardwaarde, dus een zelf ingestelde aanbieder moet de Responses API aanbieden.
Waarom is het contextvenster in Codex kleiner dan dat van het model?
Codex heeft geen metadata voor model-ID's die het niet kent en valt terug op een venster van 272.000 tokens. De instelling model_context_window kan die waarde verlagen, maar niet verhogen.
Kan ik Codex-gebruik betalen met een AI Coding Plan?
Ja. Een sleutel die je op een AI Coding Plan van Nodion aanmaakt, gebruikt het inbegrepen gebruik van het plan voor chat en tools, geteld in vensters van 5 uur, een week en een maand. Sleutels zonder plan betalen uit het prepaid tegoed.