
Passez à une API compatible OpenAI avec un routage limité à l'UE
 Niklas KarolyFondateur de Nodion
En bref
- Nodion AI Inference, sur https://api.nodion.ai/v1, suit le format de l'API OpenAI : pour les appels pris en charge, les SDK officiels d'OpenAI fonctionnent dès que vous changez l'URL de base, la clé d'API et l'identifiant du modèle.
- L'API couvre les chat completions, les embeddings, le rerank, l'OCR, la transcription audio, la synthèse vocale, la génération d'images, les outils web et les décisions System One.
- Chaque projet peut restreindre les régions autorisées à servir ses requêtes et activer la zero data retention dans l'onglet Settings d'AI Inference.
- L'usage est facturé au token, ou à la page, à la seconde, au caractère, à l'image ou à l'appel (web_search aussi par page récupérée), sur un solde prépayé ; les modèles et les prix figurent sur AI Inference.
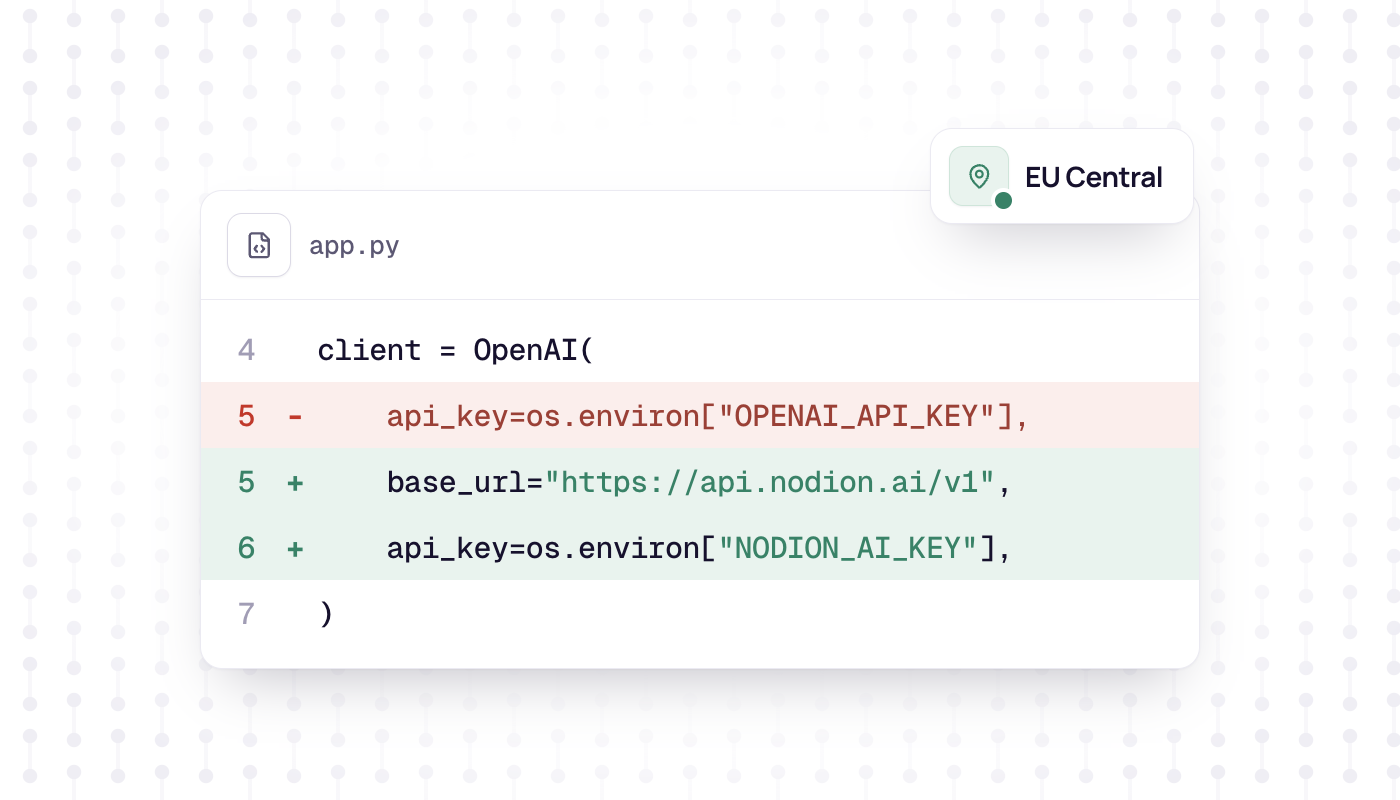
Si votre code appelle déjà l'API OpenAI, trois changements suffisent pour transférer vers Nodion AI Inference les appels pris en charge, comme les chat completions : l'URL de base, la clé d'API et l'identifiant du modèle. L'API sur https://api.nodion.ai/v1 suit le format d'OpenAI : les SDK officiels d'OpenAI pour Python et Node.js continuent donc de fonctionner. Avant de migrer d'autres appels, vérifiez que les endpoints et les fonctionnalités que vous utilisez sont pris en charge.
Nodion AI Inference est un service de Nodion GmbH, en Allemagne. Il est facturé au token sur un solde prépayé et garde les clés, l'usage et les paramètres de confidentialité dans le même projet que votre app. Certains modèles tournent chez Nodion, d'autres sont acheminés vers un fournisseur. Pour garder le traitement dans l'UE et exiger la zero data retention, définissez sur le projet une liste de régions autorisées limitée à l'UE et la politique zero data retention, comme expliqué ci-dessous.
Ce qu'il vous faut
- Un compte Nodion et un projet. Ouvrez AI Inference dans ce projet.
- Une clé d'inférence créée dans l'onglet Keys. Les clés d'inférence commencent par
nodion_ai_et ne s'affichent qu'une fois. Les clés de l'API de la plateforme Nodion ne fonctionnent pas ici. - Du crédit sur le solde prépayé. Rechargez-le par carte ou PayPal dans l'onglet Billing.
Option 1 : changez deux variables d'environnement
Les deux SDK d'OpenAI lisent l'URL de base et la clé dans l'environnement quand vous créez le client sans arguments. Si votre code appelle OpenAI() en Python ou new OpenAI() en Node.js, définissez ces deux variables, remplacez l'identifiant du modèle par celui d'un modèle Nodion et laissez le reste du code tel quel :
OPENAI_BASE_URL=https://api.nodion.ai/v1
OPENAI_API_KEY=nodion_ai_your_key
Option 2 : changez les paramètres dans le code
Si vous passez les paramètres dans le code, ajoutez l'URL de base et remplacez la clé. Python :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nodion.ai/v1",
    api_key=os.environ["NODION_AI_KEY"],
)
reply = client.chat.completions.create(
    model="<model>",
    messages=[{"role": "user", "content": "Hello"}],
)
print(reply.choices[0].message.content)
Node.js :
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nodion.ai/v1",
  apiKey: process.env.NODION_AI_KEY,
});
const reply = await client.chat.completions.create({
  model: "<model>",
  messages: [{ role: "user", content: "Hello" }],
});
console.log(reply.choices[0].message.content);
Le streaming, les appels d'outils (tool calls), le mode JSON et la sortie structurée utilisent les mêmes appels du SDK qu'avant, tant que le modèle les prend en charge.
Choisissez un modèle
Il ne reste qu'une chose à changer, la valeur de model, car Nodion utilise ses propres identifiants de modèle. Un seul appel les liste, et il ne demande pas de clé :
curl https://api.nodion.ai/v1/modelsChaque entrée contient un id à envoyer comme model, son kind (chat, embeddings ou rerank), la longueur de contexte et de sortie, le prix par token en USD et en EUR, et des supported_features comme tools, json_mode, structured_outputs ou reasoning. Le champ serving indique si les poids tournent chez Nodion (hosted) ou si la requête est transmise à un fournisseur (routed).
Les modèles d'OCR, de voix, d'image et d'outils ne figurent pas dans cette liste. Le catalogue complet avec les prix se trouve sur AI Inference et dans l'onglet Models du dashboard. Les modèles marqués Preview peuvent quitter le catalogue à bref délai.
Les endpoints disponibles
Voici les principaux endpoints sur api.nodion.ai/v1 ; la liste complète figure dans la référence de l'API.
| Endpoint | Rôle | Facturé par |
|---|---|---|
GET /v1/models | Liste les modèles de chat, d'embeddings et de rerank | Gratuit |
POST /v1/chat/completions | Chat, outils, sortie structurée | Tokens d'entrée et de sortie |
POST /v1/embeddings | Embeddings vectoriels | Tokens d'entrée |
POST /v1/rerank | Classe des documents selon leur pertinence pour une requête | Tokens d'entrée |
POST /v1/systemone | System One : décisions typées avec probabilités | Tokens d'entrée |
POST /v1/ocr | OCR de documents et d'images | Pages |
POST /v1/audio/transcriptions, plus un WebSocket temps réel | Transcription audio (speech-to-text) | Secondes d'audio |
POST /v1/audio/speech | Synthèse vocale (text-to-speech) | Caractères |
/v1/audio/voices | Liste, crée, lit et supprime des voix clonées | Gratuit |
POST /v1/images/generations | Génération d'images | Images |
POST /v1/tools/web_search, web_news, web_fetch, web_images, web_videos, web_places, web_maps, web_shopping, web_lens | Outils web | Appels ; web_search aussi par page récupérée |
Ce qui fonctionne différemment
- Longueur de sortie : sans
max_tokens, la passerelle le fixe à la longueur de sortie maximale du modèle. Les valeurs plus élevées sont ramenées à ce maximum. - Usage en streaming : la passerelle active
stream_options.include_usage, si bien que le dernier chunk contient normalement le nombre de tokens. - PDF : envoyez-les inline sous forme de bloc de contenu
fileavec une data URI en base64. Les 20 premières pages sont rendues en images : il faut donc un modèle qui accepte les images en entrée. Les référencesfile_idsont refusées. - Images : la génération d'images renvoie uniquement du
b64_json, pas d'URL. - Erreurs : l'enveloppe d'erreur d'OpenAI, avec 402 quand le solde ne couvre pas une requête et 429 quand une limite de clé est atteinte. Chaque réponse porte un en-tête
X-Request-IDà communiquer au support. - Limites : par défaut, 300 requêtes et 2 000 000 de tokens par minute, et 10 requêtes simultanées par clé. Contactez le support si vous avez besoin de plus.
Confidentialité : zero data retention et régions par projet
L'onglet Settings d'AI Inference contrôle la façon dont les requêtes d'un projet sont traitées :
- autoriser ou exclure des fournisseurs,
- une liste facultative de régions autorisées, qui restreint les régions pouvant servir le projet,
- des options de politique comme la zero data retention.
Les paramètres s'appliquent au projet et couvrent donc toutes ses clés. Si aucune route disponible pour un modèle n'y correspond, la requête échoue avec une erreur 503. Séparez les projets aux besoins de confidentialité différents, par exemple un pour les données clients et un pour les expérimentations internes.
Facturation : un solde prépayé, au token
Les dépenses d'IA sont prélevées sur un solde prépayé, distinct de la facture mensuelle de la plateforme. Vous le rechargez par carte ou PayPal dans l'onglet Billing, ou vous activez la recharge automatique.
- Le chat est facturé sur les tokens d'entrée et de sortie au prix du modèle, et l'entrée en cache au prix du cache lorsque la route le remonte.
- Les embeddings, le rerank et System One sont facturés sur les tokens d'entrée. L'OCR est facturé à la page, la transcription audio à la seconde d'audio, la synthèse vocale au caractère, les images à l'image et les outils web à l'appel,
web_searchétant en plus facturé pour chaque page qu'il récupère. - Avant un appel, le solde réserve un montant plafond correspondant à son coût maximal. Le montant final est ensuite calculé d'après l'usage mesuré, sans dépasser la réservation, et le reste est libéré.
- Chaque clé peut avoir une limite de dépenses quotidienne, et vous pouvez fixer une limite de dépenses mensuelle dans l'onglet Billing.
Les prix par modèle figurent sur AI Inference, pas dans la grille tarifaire de la plateforme.
Prochaines étapes
- Tous les endpoints avec exemples, limites et codes d'erreur : Référence de l'API IA.
- Clés, solde et onglets du dashboard : documentation AI Inference.
- Testez un modèle avant de migrer : l'onglet Playground exécute le chat et d'autres modes. Le trafic du Playground est mesuré comme n'importe quelle autre requête.
- Vous voulez plutôt que votre agent de code gère des apps et des bases de données ? Pour cela, utilisez MCP avec une clé de plateforme, pas une clé d'inférence.
Questions fréquentes
Le SDK OpenAI fonctionne-t-il avec Nodion AI Inference ?
Oui. L'API suit le format d'OpenAI : pour les appels pris en charge, les SDK officiels Python et Node.js fonctionnent si vous réglez l'URL de base sur https://api.nodion.ai/v1 et utilisez une clé d'inférence et un identifiant de modèle Nodion. Vérifiez la prise en charge des endpoints et des fonctionnalités avant de migrer d'autres appels.
Comment changer l'URL de base du SDK OpenAI pour Python ?
Passez base_url="https://api.nodion.ai/v1" et votre clé à OpenAI(), ou définissez les variables d'environnement OPENAI_BASE_URL et OPENAI_API_KEY, que le SDK lit quand vous ne passez aucun argument.
Puis-je restreindre l'endroit où mes requêtes d'IA sont traitées ?
Oui, par projet. L'onglet Settings d'AI Inference propose une liste facultative de régions autorisées, des contrôles par fournisseur et une option zero data retention. Si aucune route disponible ne correspond à ces paramètres, la requête échoue avec une erreur 503.
Comment Nodion AI Inference est-il facturé ?
Sur un solde prépayé que vous rechargez par carte ou PayPal, distinct de la facture de la plateforme. Le chat est facturé par token d'entrée et de sortie au prix du modèle ; les autres endpoints facturent à la page, à la seconde d'audio, au caractère, à l'image ou à l'appel, et web_search aussi par page récupérée.