
Stap over op een OpenAI-compatibele API met routing alleen in de EU
 Niklas KarolyOprichter van Nodion
In het kort
- Nodion AI Inference op https://api.nodion.ai/v1 volgt de opbouw van de OpenAI API, dus voor ondersteunde calls werken de officiële OpenAI SDK's zodra je de base-URL, de API-sleutel en de model-ID aanpast.
- De API dekt chat completions, embeddings, rerank, OCR, spraak naar tekst, tekst naar spraak, het genereren van afbeeldingen, webtools en beslissingen met System One.
- Elk project kan op het tabblad Settings van AI Inference beperken welke regio's de requests mogen afhandelen, en zero data retention aanzetten.
- Gebruik wordt per token gefactureerd, of per pagina, seconde, teken, afbeelding of call (web_search ook per opgehaalde pagina), vanuit een prepaid tegoed; modellen en prijzen staan op AI Inference.
Roept je code de OpenAI-API al aan? Dan zijn er drie wijzigingen nodig om ondersteunde calls zoals chat completions naar Nodion AI Inference te verplaatsen: de base-URL, de API-sleutel en de model-id. De API op https://api.nodion.ai/v1 volgt de opbouw van de OpenAI-API, dus de officiële OpenAI-SDK's voor Python en Node.js blijven werken. Controleer wel of de endpoints en functies die je gebruikt worden ondersteund voordat je andere calls verplaatst.
Nodion AI Inference is een dienst van Nodion GmbH uit Duitsland. Je betaalt per token vanuit een prepaid tegoed, en sleutels, gebruik en privacyinstellingen staan in hetzelfde project als je app. Sommige modellen draaien op Nodion, andere worden naar een aanbieder gerouteerd. Wil je de verwerking in de EU houden en zero data retention verplicht stellen? Stel dan in het project een regio-allowlist met alleen EU-regio's in en zet het beleid voor zero data retention aan, zoals hieronder beschreven.
Wat je nodig hebt
- Een Nodion-account en een project. Open AI Inference in dat project.
- Een inference-sleutel van het tabblad Keys. Inference-sleutels beginnen met
nodion_ai_en worden maar één keer getoond. Sleutels voor de API van het Nodion-platform werken hier niet. - Prepaid tegoed. Vul het aan met je kaart of via PayPal op het tabblad Billing.
Optie 1: wijzig twee omgevingsvariabelen
Beide OpenAI-SDK's lezen de base-URL en de sleutel uit de omgeving als je de client zonder argumenten aanmaakt. Roept je code OpenAI() aan in Python of new OpenAI() in Node.js? Stel dan deze twee variabelen in, verander de model-id in die van een Nodion-model en laat de rest van de code zoals die is:
OPENAI_BASE_URL=https://api.nodion.ai/v1
OPENAI_API_KEY=nodion_ai_your_key
Optie 2: wijzig de instellingen in de code
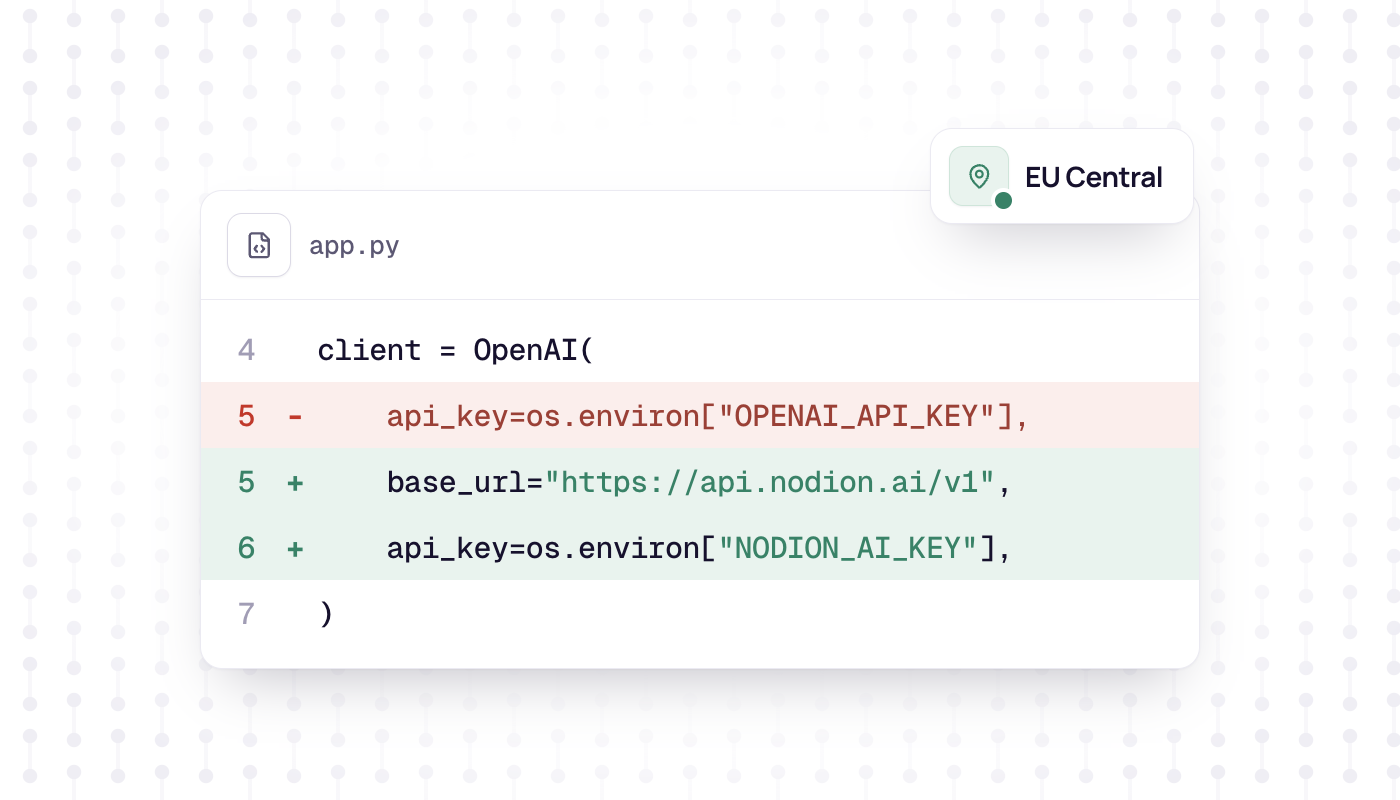
Geef je de instellingen in de code mee? Voeg dan de base-URL toe en vervang de sleutel. Python:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nodion.ai/v1",
    api_key=os.environ["NODION_AI_KEY"],
)
reply = client.chat.completions.create(
    model="<model>",
    messages=[{"role": "user", "content": "Hello"}],
)
print(reply.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nodion.ai/v1",
  apiKey: process.env.NODION_AI_KEY,
});
const reply = await client.chat.completions.create({
  model: "<model>",
  messages: [{ role: "user", content: "Hello" }],
});
console.log(reply.choices[0].message.content);
Streaming, tool calls, JSON-modus en structured output gebruiken dezelfde SDK-calls als voorheen, zolang het model ze ondersteunt.
Kies een model
Alleen de waarde van model moet nog veranderen, want Nodion gebruikt eigen model-id's. Eén call geeft de lijst, en daarvoor heb je geen sleutel nodig:
curl https://api.nodion.ai/v1/modelsElk item bevat de id die je als model meestuurt, de waarde van kind (chat, embeddings of rerank), de context- en outputlengte, de prijs per token in USD en EUR, en supported_features zoals tools, json_mode, structured_outputs of reasoning. Het veld serving geeft aan of de gewichten op Nodion draaien (hosted) of dat het request naar een aanbieder wordt doorgestuurd (routed).
OCR-, spraak-, beeld- en toolmodellen staan niet in die lijst. De volledige catalogus met prijzen vind je op AI Inference en op het tabblad Models in het dashboard. Modellen met het label Preview kunnen op korte termijn uit de catalogus verdwijnen.
Welke endpoints er zijn
Dit zijn de belangrijkste endpoints op api.nodion.ai/v1; de volledige lijst staat in de API-referentie.
| Endpoint | Wat het doet | Facturering |
|---|---|---|
GET /v1/models | Chat-, embeddings- en rerankmodellen weergeven | Gratis |
POST /v1/chat/completions | Chat, tools, structured output | Input- en outputtokens |
POST /v1/embeddings | Vector-embeddings | Inputtokens |
POST /v1/rerank | Documenten rangschikken op relevantie voor een query | Inputtokens |
POST /v1/systemone | System One: getypeerde beslissingen met waarschijnlijkheden | Inputtokens |
POST /v1/ocr | OCR van documenten en afbeeldingen | Pagina's |
POST /v1/audio/transcriptions, plus een realtime WebSocket | Spraak naar tekst | Audioseconden |
POST /v1/audio/speech | Tekst naar spraak | Tekens |
/v1/audio/voices | Gekloonde stemmen weergeven, aanmaken, lezen en verwijderen | Gratis |
POST /v1/images/generations | Afbeeldingen genereren | Afbeeldingen |
POST /v1/tools/web_search, web_news, web_fetch, web_images, web_videos, web_places, web_maps, web_shopping, web_lens | Webtools | Calls; web_search ook per opgehaalde pagina |
Wat anders werkt
- Outputlengte: zonder
max_tokenszet de gateway die waarde op de maximale outputlengte van het model. Hogere waarden worden tot dat maximum verlaagd. - Gebruik in streams: de gateway zet
stream_options.include_usageaan, zodat de laatste chunk normaal gesproken de tokenaantallen bevat. - PDF's: stuur ze inline mee als contentblok van het type
filemet een base64-data-URI. De eerste 20 pagina's worden naar afbeeldingen gerenderd, dus je hebt een model met beeldinvoer nodig. Verwijzingen viafile_idworden geweigerd. - Afbeeldingen: het genereren van afbeeldingen levert alleen
b64_jsonop, geen URL's. - Fouten: het foutformaat van OpenAI, met 402 als het tegoed een request niet dekt en 429 als een sleutellimiet is bereikt. Elke response bevat een header
X-Request-IDdie je aan support kunt doorgeven. - Limieten: standaard 300 requests en 2.000.000 tokens per minuut en 10 gelijktijdige requests per sleutel. Heb je meer nodig, neem dan contact op met support.
Privacy: zero data retention en regio's per project
Het tabblad Settings van AI Inference bepaalt hoe de requests van een project worden afgehandeld:
- aanbieders toestaan of uitsluiten,
- een optionele regio-allowlist die beperkt welke regio's het project mogen bedienen,
- beleidsinstellingen zoals zero data retention.
De instellingen gelden voor het project en dus voor elke sleutel erin. Past geen enkele gezonde route voor een model bij deze instellingen, dan mislukt het request met een 503. Houd projecten met verschillende privacy-eisen gescheiden, bijvoorbeeld één voor klantgegevens en één voor interne experimenten.
Facturering: prepaid tegoed, per token
Uitgaven aan AI gaan van een prepaid tegoed af, los van de maandelijkse factuur voor het platform. Je vult het aan met je kaart of via PayPal op het tabblad Billing, of je zet automatisch opwaarderen aan.
- Chat wordt gefactureerd op input- en outputtokens tegen de prijs van het model, en gecachete input tegen de cacheprijs als de route die rapporteert.
- Embeddings, rerank en System One worden gefactureerd op inputtokens. OCR wordt per pagina gefactureerd, spraak naar tekst per audioseconde, tekst naar spraak per teken, afbeeldingen per afbeelding en webtools per call, waarbij
web_searchook per opgehaalde pagina wordt gefactureerd. - Voor een call wordt een maximaal bedrag van je tegoed gereserveerd. Het request wordt daarna afgerekend op basis van het gerapporteerde gebruik, nooit boven de reservering, en de rest komt weer vrij.
- Elke sleutel kan een dagelijkse uitgavenlimiet hebben, en op het tabblad Billing kun je een maandelijkse uitgavenlimiet instellen.
Prijzen per model staan op AI Inference, niet in de prijslijst van het platform.
Volgende stappen
- Alle endpoints met voorbeelden, limieten en foutcodes: AI-API-referentie.
- Sleutels, tegoed en de tabbladen in het dashboard: documentatie van AI Inference.
- Probeer een model uit voordat je overstapt: op het tabblad Playground kun je chat en andere modi testen. Verkeer via de Playground wordt gemeten zoals elk ander request.
- Wil je liever dat je coding agent apps en databases beheert? Daarvoor gebruik je MCP met een platformsleutel, geen inference-sleutel.
Veelgestelde vragen
Werkt de OpenAI SDK met Nodion AI Inference?
Ja. De API volgt de opbouw van OpenAI, dus voor ondersteunde calls werken de officiële SDK's voor Python en Node.js als je de base-URL op https://api.nodion.ai/v1 zet en een inference-sleutel en model-ID van Nodion gebruikt. Controleer of endpoints en functies worden ondersteund voordat je andere calls verplaatst.
Hoe verander ik de base-URL van de OpenAI Python SDK?
Geef base_url="https://api.nodion.ai/v1" en je sleutel mee aan OpenAI(), of stel de omgevingsvariabelen OPENAI_BASE_URL en OPENAI_API_KEY in. De SDK leest die als je geen argumenten meegeeft.
Kan ik beperken waar mijn AI-requests worden verwerkt?
Ja, per project. Het tabblad Settings van AI Inference heeft een optionele regio-allowlist, instellingen per aanbieder en een schakelaar voor zero data retention. Past geen enkele gezonde route bij deze instellingen, dan mislukt het request met een 503.
Hoe wordt Nodion AI Inference gefactureerd?
Vanuit een prepaid tegoed dat je opwaardeert met je kaart of via PayPal, los van de factuur voor het platform. Chat wordt per input- en outputtoken gefactureerd tegen de prijs van het model; andere endpoints factureren per pagina, audioseconde, teken, afbeelding of call, en web_search ook per opgehaalde pagina.