
Przejdź na API zgodne z OpenAI z routingiem wyłącznie w UE
 Niklas KarolyZałożyciel Nodion
W skrócie
- Nodion AI Inference pod adresem https://api.nodion.ai/v1 jest zgodne z formatem API OpenAI, więc przy obsługiwanych wywołaniach oficjalne SDK OpenAI działają po zmianie bazowego URL, klucza API i ID modelu.
- API obejmuje chat completions, embeddingi, rerank, OCR, zamianę mowy na tekst i tekstu na mowę, generowanie obrazów, narzędzia webowe i decyzje System One.
- Każdy projekt może w zakładce Settings w AI Inference ograniczyć, które regiony obsługują jego żądania, i włączyć zero data retention.
- Zużycie jest rozliczane za tokeny albo za stronę, sekundę, znak, obraz lub wywołanie (web_search także za każdą pobraną stronę) z przedpłaconego salda; modele i ceny znajdziesz na stronie AI Inference.
Jeśli Twój kod już wywołuje API OpenAI, przeniesienie obsługiwanych wywołań, takich jak chat completions, do Nodion AI Inference wymaga trzech zmian: adresu bazowego, klucza API i identyfikatora modelu. API pod adresem https://api.nodion.ai/v1 ma format zgodny z API OpenAI, więc oficjalne SDK OpenAI dla Pythona i Node.js nadal działają. Zanim przeniesiesz inne wywołania, sprawdź, czy endpointy i funkcje, z których korzystasz, są obsługiwane.
Nodion AI Inference to usługa Nodion GmbH z Niemiec. Za tokeny płacisz ze środków na saldzie przedpłaconym, a klucze, zużycie i ustawienia prywatności znajdują się w tym samym projekcie co Twoja aplikacja. Część modeli działa na Nodion, a żądania do pozostałych są kierowane do zewnętrznych dostawców. Jeśli przetwarzanie ma pozostać w UE, a dostawcy mają stosować zero data retention, ustaw w projekcie listę dozwolonych regionów ograniczoną do UE oraz zasadę zero data retention, jak opisano niżej.
Co jest potrzebne
- Konto Nodion i projekt. Otwórz w tym projekcie AI Inference.
- Klucz inferencji z zakładki Keys. Klucze inferencji zaczynają się od
nodion_ai_i są pokazywane tylko raz. Klucze do API platformy Nodion tutaj nie działają. - Środki na saldzie. Doładujesz je kartą lub przez PayPal w zakładce Billing.
Opcja 1: zmień dwie zmienne środowiskowe
Oba SDK OpenAI odczytują adres bazowy i klucz ze zmiennych środowiskowych, gdy tworzysz klienta bez argumentów. Jeśli Twój kod wywołuje OpenAI() w Pythonie albo new OpenAI() w Node.js, ustaw te dwie zmienne, zmień identyfikator modelu na identyfikator modelu Nodion i zostaw resztę kodu bez zmian:
OPENAI_BASE_URL=https://api.nodion.ai/v1
OPENAI_API_KEY=nodion_ai_your_key
Opcja 2: zmień ustawienia w kodzie
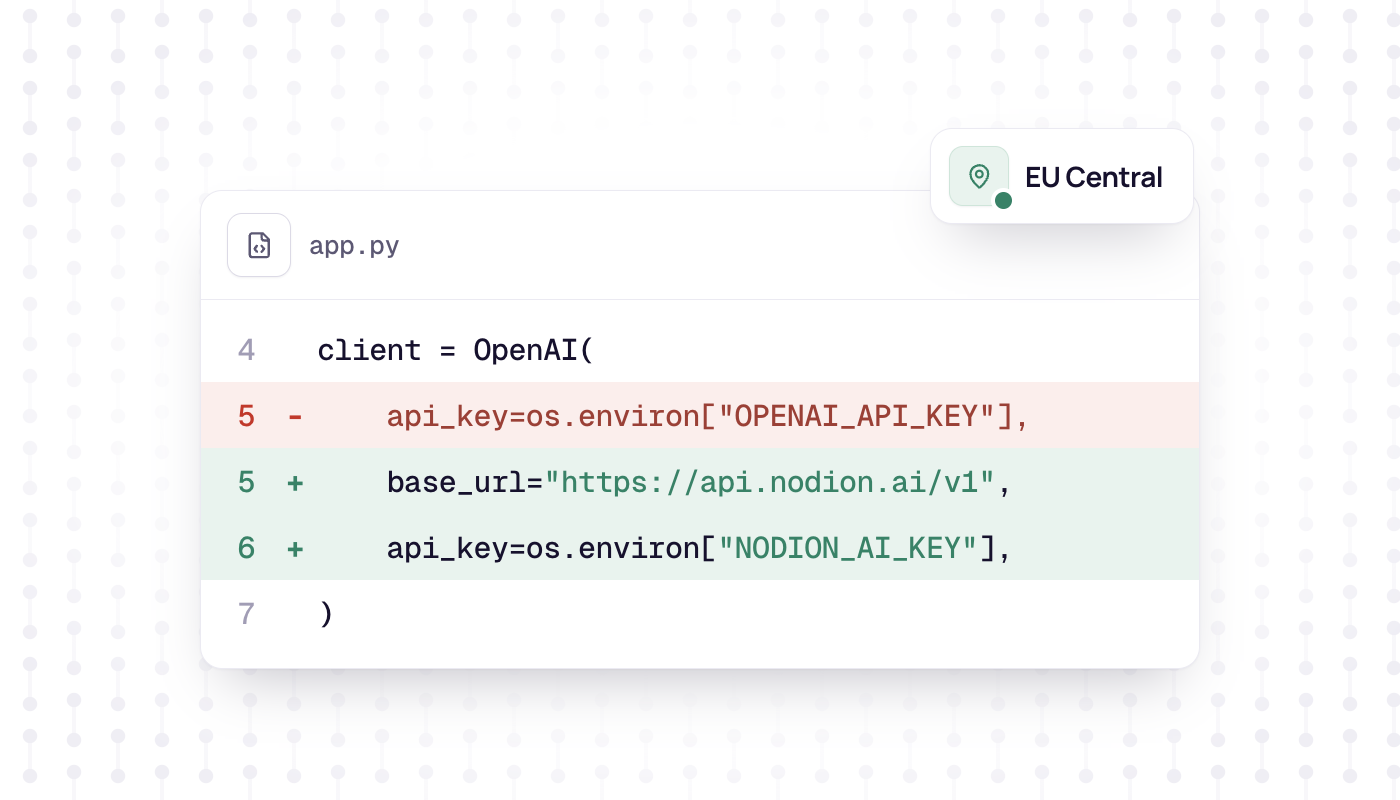
Jeśli przekazujesz ustawienia w kodzie, dodaj adres bazowy i podmień klucz. Python:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nodion.ai/v1",
    api_key=os.environ["NODION_AI_KEY"],
)
reply = client.chat.completions.create(
    model="<model>",
    messages=[{"role": "user", "content": "Hello"}],
)
print(reply.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nodion.ai/v1",
  apiKey: process.env.NODION_AI_KEY,
});
const reply = await client.chat.completions.create({
  model: "<model>",
  messages: [{ role: "user", content: "Hello" }],
});
console.log(reply.choices[0].message.content);
Streaming, wywołania narzędzi (tool calls), tryb JSON i structured output działają przez te same wywołania SDK co wcześniej, o ile model je obsługuje.
Wybierz model
Do zmiany zostaje już tylko wartość model, bo Nodion używa własnych identyfikatorów modeli. Jedno wywołanie zwraca ich listę i nie wymaga klucza:
curl https://api.nodion.ai/v1/modelsKażdy wpis zawiera id, które wysyłasz jako model, typ kind (chat, embeddings lub rerank), maksymalną długość kontekstu i odpowiedzi, cenę za token w USD i EUR oraz supported_features, takie jak tools, json_mode, structured_outputs czy reasoning. Pole serving wskazuje, czy model działa na Nodion (hosted), czy żądanie jest przekazywane do dostawcy (routed).
Modeli OCR, mowy, obrazów i narzędzi nie ma na tej liście. Pełny katalog z cenami znajdziesz na stronie AI Inference i w zakładce Models w dashboardzie. Modele oznaczone jako Preview mogą zniknąć z katalogu z krótkim wyprzedzeniem.
Dostępne endpointy
Oto główne endpointy w api.nodion.ai/v1; pełną listę znajdziesz w dokumentacji API.
| Endpoint | Do czego służy | Rozliczane według |
|---|---|---|
GET /v1/models | Lista modeli chat, embeddings i rerank | Bezpłatnie |
POST /v1/chat/completions | Chat, narzędzia, structured output | Tokeny wejściowe i wyjściowe |
POST /v1/embeddings | Embeddingi wektorowe | Tokeny wejściowe |
POST /v1/rerank | Ranking dokumentów względem zapytania | Tokeny wejściowe |
POST /v1/systemone | System One: typowane decyzje z prawdopodobieństwami | Tokeny wejściowe |
POST /v1/ocr | OCR dokumentów i obrazów | Strony |
POST /v1/audio/transcriptions oraz WebSocket w czasie rzeczywistym | Zamiana mowy na tekst | Sekundy audio |
POST /v1/audio/speech | Zamiana tekstu na mowę | Znaki |
/v1/audio/voices | Wyświetlanie listy, tworzenie, odczyt i usuwanie sklonowanych głosów | Bezpłatnie |
POST /v1/images/generations | Generowanie obrazów | Obrazy |
POST /v1/tools/web_search, web_news, web_fetch, web_images, web_videos, web_places, web_maps, web_shopping, web_lens | Narzędzia webowe | Wywołania; web_search także za każdą pobraną stronę |
Co działa inaczej
- Długość odpowiedzi: bez
max_tokensbramka AI ustawia tę wartość na maksymalną długość odpowiedzi modelu. Większe wartości są obniżane do tego limitu. - Zużycie w streamingu: bramka AI włącza
stream_options.include_usage, więc ostatni fragment zwykle zawiera liczbę tokenów. - Pliki PDF: wysyłaj je bezpośrednio jako blok treści
filez data URI w base64. Pierwsze 20 stron jest renderowanych do obrazów, więc potrzebny jest model obsługujący obrazy na wejściu. Odwołaniafile_idsą odrzucane. - Obrazy: generowanie obrazów zwraca wyłącznie
b64_json, bez adresów URL. - Błędy: format błędów OpenAI, z kodem 402, gdy saldo nie pokrywa żądania, i 429, gdy zostanie osiągnięty limit klucza. Każda odpowiedź ma nagłówek
X-Request-ID, który warto podać w zgłoszeniu do działu wsparcia. - Limity: domyślnie 300 żądań i 2 000 000 tokenów na minutę oraz 10 równoczesnych żądań na klucz. Jeśli potrzebujesz więcej, skontaktuj się z działem wsparcia.
Prywatność: zero data retention i regiony dla każdego projektu
Zakładka Settings w AI Inference określa, jak obsługiwane są żądania projektu:
- dopuszczanie lub wykluczanie dostawców,
- opcjonalna lista dozwolonych regionów, która ogranicza, z jakich regionów można obsługiwać projekt,
- przełączniki zasad, takie jak zero data retention.
Ustawienia dotyczą projektu, więc obejmują każdy klucz w nim. Jeśli żadna sprawna trasa dla danego modelu do nich nie pasuje, żądanie kończy się błędem 503. Projekty o różnych wymaganiach dotyczących prywatności trzymaj osobno, na przykład jeden na dane klientów, a drugi na wewnętrzne eksperymenty.
Rozliczenia: przedpłacone saldo, za tokeny
Koszty AI są pobierane z przedpłaconego salda, oddzielnego od miesięcznej faktury za platformę. Doładowujesz je kartą lub przez PayPal w zakładce Billing albo włączasz automatyczne doładowanie.
- Chat jest rozliczany za tokeny wejściowe i wyjściowe według ceny modelu, a wejście z cache według ceny cache, jeśli trasa to raportuje.
- Embeddingi, rerank i System One są rozliczane za tokeny wejściowe. OCR jest rozliczany za stronę, zamiana mowy na tekst za sekundę audio, zamiana tekstu na mowę za znak, obrazy za obraz, a narzędzia webowe za wywołanie, przy czym
web_searchjest dodatkowo rozliczane za każdą pobraną stronę. - Przed wywołaniem na saldzie blokowana jest kwota odpowiadająca maksymalnemu kosztowi żądania. Żądanie jest potem rozliczane według raportowanego zużycia, nigdy powyżej zablokowanej kwoty, a reszta zostaje zwolniona.
- Każdy klucz może mieć dzienny limit wydatków, a w zakładce Billing możesz ustawić miesięczny limit wydatków.
Ceny poszczególnych modeli znajdziesz na stronie AI Inference, a nie w cenniku platformy.
Co dalej
- Wszystkie endpointy z przykładami, limitami i kodami błędów: dokumentacja API AI.
- Klucze, saldo i zakładki dashboardu: dokumentacja AI Inference.
- Przetestuj model przed przejściem: zakładka Playground obsługuje chat i inne tryby. Ruch z Playground jest liczony jak każde inne żądanie.
- Chcesz raczej, żeby Twój agent do kodowania zarządzał aplikacjami i bazami danych? Do tego służy MCP z kluczem platformy, a nie kluczem inferencji.
Najczęściej zadawane pytania
Czy SDK OpenAI działa z Nodion AI Inference?
Tak. API jest zgodne z formatem OpenAI, więc przy obsługiwanych wywołaniach oficjalne SDK dla Pythona i Node.js działają, gdy ustawisz bazowy URL na https://api.nodion.ai/v1 i użyjesz klucza inferencji oraz ID modelu Nodion. Zanim przeniesiesz inne wywołania, sprawdź obsługę endpointów i funkcji.
Jak zmienić bazowy URL w SDK OpenAI dla Pythona?
Przekaż base_url="https://api.nodion.ai/v1" i swój klucz do OpenAI() albo ustaw zmienne środowiskowe OPENAI_BASE_URL i OPENAI_API_KEY, które SDK odczytuje, gdy nie przekazujesz argumentów.
Czy mogę ograniczyć, gdzie przetwarzane są moje żądania do AI?
Tak, dla każdego projektu osobno. Zakładka Settings w AI Inference zawiera opcjonalną listę dozwolonych regionów, ustawienia dostawców i przełącznik zero data retention. Jeśli żadna sprawna trasa nie pasuje do tych ustawień, żądanie kończy się błędem 503.
Jak rozliczane jest Nodion AI Inference?
Z przedpłaconego salda, które doładowujesz kartą lub przez PayPal, oddzielnie od faktury za platformę. Chat jest rozliczany za tokeny wejściowe i wyjściowe według ceny modelu; inne endpointy rozliczają za stronę, sekundę audio, znak, obraz lub wywołanie, a web_search także za każdą pobraną stronę.