
Passa a un'API compatibile con OpenAI con routing solo nell'UE
 Niklas KarolyFondatore di Nodion
In breve
- Nodion AI Inference su https://api.nodion.ai/v1 segue la struttura dell'API di OpenAI, quindi per le chiamate supportate gli SDK ufficiali di OpenAI funzionano dopo aver cambiato base URL, chiave API e ID del modello.
- L'API copre chat completions, embeddings, rerank, OCR, trascrizione (speech to text), sintesi vocale (text to speech), generazione di immagini, tool web e decisioni System One.
- Ogni progetto può limitare quali regioni possono servire le sue richieste e attivare la zero data retention nella scheda Settings di AI Inference.
- L'utilizzo è fatturato per token, oppure per pagina, secondo, carattere, immagine o chiamata (web_search anche per pagina recuperata), dal credito prepagato; modelli e prezzi sono su AI Inference.
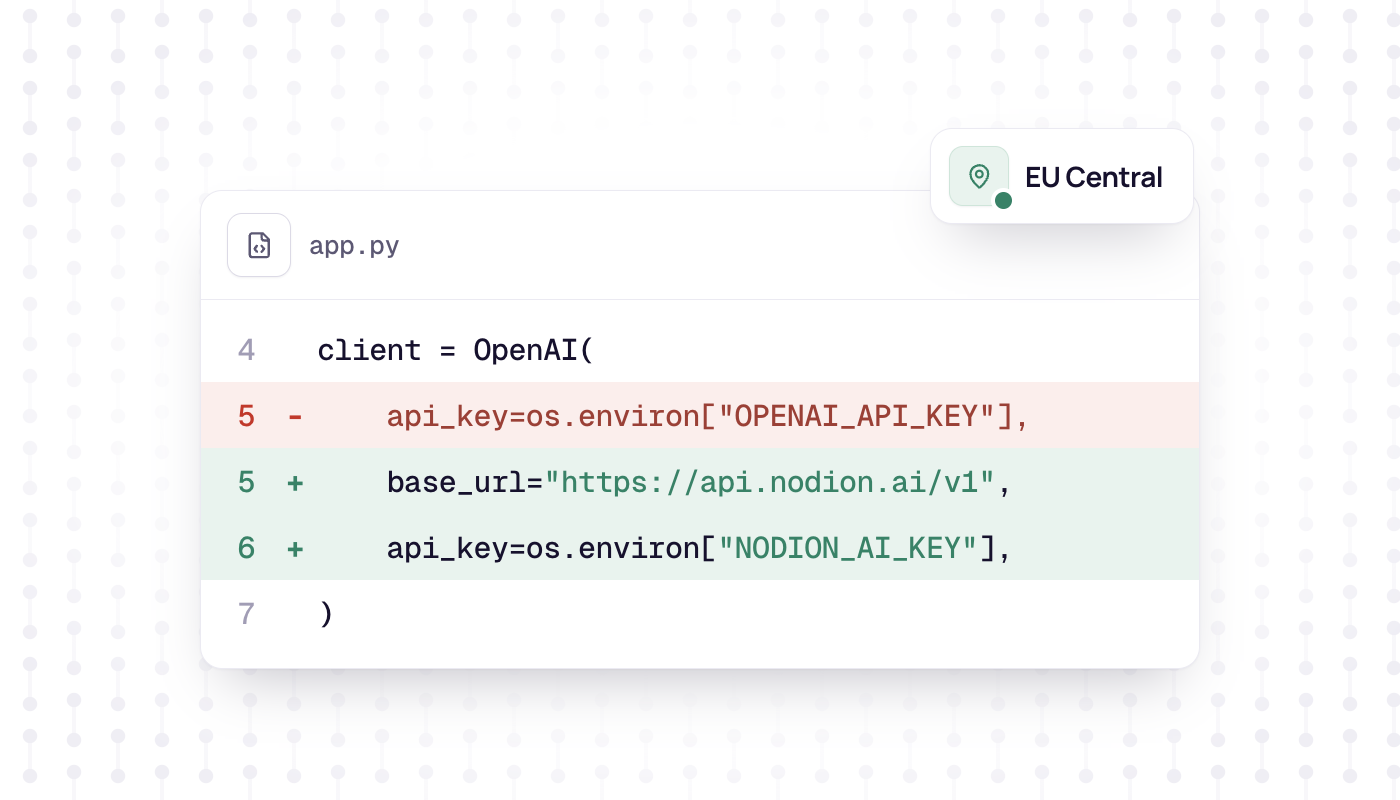
Se il tuo codice usa già l'API di OpenAI, per spostare su Nodion AI Inference le chiamate supportate, come le chat completions, devi cambiare tre cose: il base URL, la chiave API e l'ID del modello. L'API su https://api.nodion.ai/v1 segue la struttura di OpenAI, quindi gli SDK ufficiali di OpenAI per Python e Node.js continuano a funzionare. Prima di spostare altre chiamate, verifica che gli endpoint e le funzionalità che usi siano supportati.
Nodion AI Inference è un servizio di Nodion GmbH, in Germania, fattura per token dal credito prepagato e tiene chiavi, utilizzo e impostazioni sulla privacy nello stesso progetto della tua app. Alcuni modelli girano su Nodion, altri vengono instradati verso un provider. Per mantenere l'elaborazione nell'UE e richiedere zero data retention, imposta sul progetto un elenco di regioni consentite limitato all'UE e la policy di zero data retention, come mostrato qui sotto.
Cosa ti serve
- Un account Nodion e un progetto. Apri AI Inference in quel progetto.
- Una chiave di inferenza dalla scheda Keys. Le chiavi di inferenza iniziano con
nodion_ai_e vengono mostrate una sola volta. Le chiavi per l'API della piattaforma Nodion qui non funzionano. - Credito disponibile. Ricaricalo con carta o PayPal nella scheda Billing.
Opzione 1: cambia due variabili d'ambiente
Entrambi gli SDK di OpenAI leggono base URL e chiave dall'ambiente quando crei il client senza argomenti. Se il tuo codice chiama OpenAI() in Python o new OpenAI() in Node.js, imposta queste due variabili, sostituisci l'ID del modello con quello di un modello Nodion e lascia il resto del codice com'è:
OPENAI_BASE_URL=https://api.nodion.ai/v1
OPENAI_API_KEY=nodion_ai_your_key
Opzione 2: cambia le impostazioni nel codice
Se passi le impostazioni nel codice, aggiungi il base URL e sostituisci la chiave. Python:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nodion.ai/v1",
    api_key=os.environ["NODION_AI_KEY"],
)
reply = client.chat.completions.create(
    model="<model>",
    messages=[{"role": "user", "content": "Hello"}],
)
print(reply.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nodion.ai/v1",
  apiKey: process.env.NODION_AI_KEY,
});
const reply = await client.chat.completions.create({
  model: "<model>",
  messages: [{ role: "user", content: "Hello" }],
});
console.log(reply.choices[0].message.content);
Streaming, chiamate ai tool, modalità JSON e output strutturato usano le stesse chiamate dell'SDK, purché il modello li supporti.
Scegli un modello
Il valore model è l'unica cosa che resta da cambiare, perché Nodion usa ID dei modelli propri. Puoi elencarli con una sola chiamata, senza chiave:
curl https://api.nodion.ai/v1/modelsOgni voce contiene l'id da inviare come model, il suo kind (chat, embeddings o rerank), la lunghezza di contesto e di output, il prezzo per token in USD ed EUR e le supported_features come tools, json_mode, structured_outputs o reasoning. Il campo serving indica se i pesi girano su Nodion (hosted) o se la richiesta viene inoltrata a un provider (routed).
I modelli di OCR, voce, immagini e tool non sono in quell'elenco. Il catalogo completo con i prezzi è su AI Inference e nella scheda Models della dashboard. I modelli contrassegnati come Preview possono uscire dal catalogo con breve preavviso.
Quali endpoint esistono
Questi sono gli endpoint principali su api.nodion.ai/v1; l'elenco completo è nel riferimento API.
| Endpoint | Cosa fa | Fatturato per |
|---|---|---|
GET /v1/models | Elenca i modelli di chat, embeddings e rerank | Gratis |
POST /v1/chat/completions | Chat, tool, output strutturato | Token di input e di output |
POST /v1/embeddings | Embedding vettoriali | Token di input |
POST /v1/rerank | Ordina documenti rispetto a una query | Token di input |
POST /v1/systemone | System One: decisioni tipizzate con probabilità | Token di input |
POST /v1/ocr | OCR di documenti e immagini | Pagine |
POST /v1/audio/transcriptions, più un WebSocket realtime | Trascrizione (speech to text) | Secondi di audio |
POST /v1/audio/speech | Sintesi vocale (text to speech) | Caratteri |
/v1/audio/voices | Elenca, crea, legge ed elimina voci clonate | Gratis |
POST /v1/images/generations | Generazione di immagini | Immagini |
POST /v1/tools/web_search, web_news, web_fetch, web_images, web_videos, web_places, web_maps, web_shopping, web_lens | Tool web | Chiamate; web_search anche per pagina recuperata |
Cosa funziona diversamente
- Lunghezza dell'output: senza
max_tokens, il gateway lo imposta alla lunghezza massima di output del modello. I valori più alti vengono ridotti a quel limite. - Utilizzo negli stream: il gateway attiva
stream_options.include_usage, quindi l'ultimo chunk di norma riporta il conteggio dei token. - PDF: inviali inline come blocco di contenuto
filecon un data URI in base64. Le prime 20 pagine vengono convertite in immagini, quindi serve un modello che accetti immagini in input. I riferimentifile_idvengono rifiutati. - Immagini: la generazione di immagini restituisce solo
b64_json, nessun URL. - Errori: seguono la struttura di OpenAI, con 402 quando il credito non copre una richiesta e 429 quando si raggiunge un limite della chiave. Ogni risposta contiene un header
X-Request-IDda indicare al supporto. - Limiti: per impostazione predefinita, 300 richieste e 2.000.000 di token al minuto e 10 richieste simultanee per chiave. Contatta il supporto se ti serve di più.
Privacy: zero data retention e regioni per progetto
La scheda Settings di AI Inference stabilisce come vengono servite le richieste di un progetto:
- consentire o escludere provider,
- un elenco facoltativo di regioni consentite, che limita quali regioni possono servire il progetto,
- opzioni di policy come la zero data retention.
Le impostazioni valgono per il progetto, quindi coprono ogni sua chiave. Se nessuna route funzionante per un modello le rispetta, la richiesta fallisce con un 503. Tieni separati i progetti con esigenze di privacy diverse, per esempio uno per i dati dei clienti e uno per gli esperimenti interni.
Fatturazione: credito prepagato, per token
La spesa per l'AI viene scalata da un credito prepagato, separato dalla fattura mensile della piattaforma. Lo ricarichi con carta o PayPal nella scheda Billing, oppure attivi la ricarica automatica.
- La chat è fatturata sui token di input e di output al prezzo del modello; l'input in cache segue il prezzo previsto per la cache, dove la route lo indica.
- Embeddings, rerank e System One sono fatturati sui token di input. L'OCR è fatturato a pagina, la trascrizione per secondo di audio, la sintesi vocale per carattere, le immagini per immagine e i tool web per chiamata, con
web_searchfatturato anche per ogni pagina che recupera. - Prima di una chiamata viene riservato sul credito un importo pari al costo massimo. La richiesta viene poi addebitata in base all'utilizzo registrato, mai oltre l'importo riservato, e il resto viene sbloccato.
- Ogni chiave può avere un limite di spesa giornaliero, e nella scheda Billing puoi impostare un limite di spesa mensile.
I prezzi per modello sono su AI Inference, non nel listino della piattaforma.
Prossimi passi
- Ogni endpoint con esempi, limiti e codici di errore: Riferimento API AI.
- Chiavi, credito e schede della dashboard: documentazione di AI Inference.
- Prova un modello prima di passare: la scheda Playground esegue la chat e altre modalità. Il traffico del Playground viene conteggiato come qualsiasi altra richiesta.
- Vuoi invece che il tuo coding agent gestisca app e database? Per quello c'è MCP con una chiave della piattaforma, non una chiave di inferenza.
Domande frequenti
L'SDK di OpenAI funziona con Nodion AI Inference?
Sì. L'API segue la struttura di OpenAI, quindi per le chiamate supportate gli SDK ufficiali per Python e Node.js funzionano se imposti il base URL su https://api.nodion.ai/v1 e usi una chiave di inferenza Nodion e un ID di modello Nodion. Prima di spostare altre chiamate, verifica il supporto di endpoint e funzionalità.
Come cambio il base URL dell'SDK Python di OpenAI?
Passa base_url="https://api.nodion.ai/v1" e la tua chiave a OpenAI(), oppure imposta le variabili d'ambiente OPENAI_BASE_URL e OPENAI_API_KEY, che l'SDK legge quando non passi argomenti.
Posso limitare dove vengono elaborate le mie richieste AI?
Sì, per progetto. La scheda Settings di AI Inference ha un elenco facoltativo di regioni consentite, controlli sui provider e un'opzione per la zero data retention. Se nessuna route funzionante rispetta queste impostazioni, la richiesta fallisce con un 503.
Come viene fatturato Nodion AI Inference?
Dal credito prepagato, che ricarichi con carta o PayPal, separato dalla fattura della piattaforma. La chat è fatturata per token di input e di output al prezzo del modello; gli altri endpoint fatturano per pagina, secondo di audio, carattere, immagine o chiamata, e web_search anche per pagina recuperata.