
Mude para uma API compatível com a OpenAI com encaminhamento só na UE
 Niklas KarolyFundador da Nodion
Em resumo
- O Nodion AI Inference, em https://api.nodion.ai/v1, segue o formato da API da OpenAI, pelo que, nas chamadas suportadas, os SDK oficiais da OpenAI funcionam depois de alterar o URL base, a chave de API e o ID do modelo.
- A API abrange chat completions, embeddings, rerank, OCR, voz para texto, texto para voz, geração de imagens, ferramentas web e decisões System One.
- Cada projeto pode restringir as regiões que servem os seus pedidos e ativar zero data retention no separador Settings do AI Inference.
- A utilização é faturada por token, ou por página, segundo, carácter, imagem ou chamada (o web_search também por página obtida), a partir de um saldo pré-pago; os modelos e os preços estão em AI Inference.
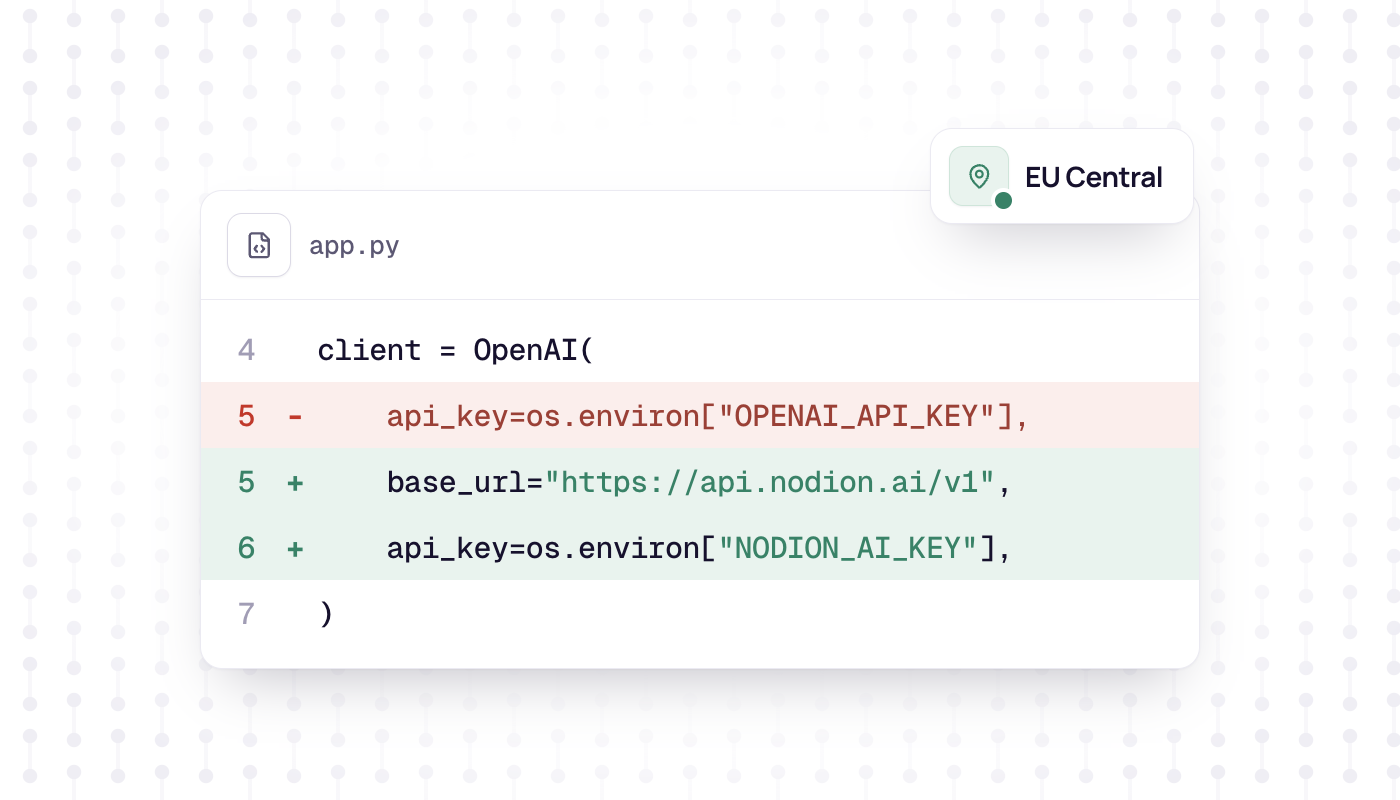
Se o seu código já chama a API da OpenAI, transferir chamadas suportadas, como chat completions, para o Nodion AI Inference exige três alterações: o URL base, a chave de API e o ID do modelo. A API em https://api.nodion.ai/v1 segue o formato da API da OpenAI, pelo que os SDK oficiais da OpenAI para Python e Node.js continuam a funcionar. Antes de transferir outras chamadas, confirme que os endpoints e as funcionalidades que utiliza são suportados.
O serviço Nodion AI Inference é da Nodion GmbH, na Alemanha. É faturado ao token a partir de um saldo pré-pago e mantém as chaves, a utilização e as definições de privacidade no mesmo projeto que a sua aplicação. Alguns modelos correm na Nodion, outros são encaminhados para um fornecedor. Para limitar o processamento à UE e exigir zero data retention, defina no projeto uma lista de regiões permitidas que inclua apenas regiões da UE e a política de zero data retention, como se mostra abaixo.
Do que precisa
- Uma conta Nodion e um projeto. Abra o AI Inference nesse projeto.
- Uma chave de inferência criada no separador Keys. As chaves de inferência começam por
nodion_ai_e só são mostradas uma vez. As chaves da API da plataforma Nodion não funcionam aqui. - Saldo pré-pago. Carregue-o com cartão ou PayPal no separador Billing.
Opção 1: altere duas variáveis de ambiente
Os dois SDK da OpenAI leem o URL base e a chave a partir do ambiente quando cria o cliente sem argumentos. Se o seu código chama OpenAI() em Python ou new OpenAI() em Node.js, defina estas duas variáveis, troque o ID do modelo pelo de um modelo da Nodion e deixe o resto do código como está:
OPENAI_BASE_URL=https://api.nodion.ai/v1
OPENAI_API_KEY=nodion_ai_your_key
Opção 2: altere as definições no código
Se passa as definições no código, adicione o URL base e troque a chave. Python:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nodion.ai/v1",
    api_key=os.environ["NODION_AI_KEY"],
)
reply = client.chat.completions.create(
    model="<model>",
    messages=[{"role": "user", "content": "Hello"}],
)
print(reply.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nodion.ai/v1",
  apiKey: process.env.NODION_AI_KEY,
});
const reply = await client.chat.completions.create({
  model: "<model>",
  messages: [{ role: "user", content: "Hello" }],
});
console.log(reply.choices[0].message.content);
O streaming, as chamadas de ferramentas (tool calls), o modo JSON e a saída estruturada (structured output) usam as mesmas chamadas do SDK que antes, desde que o modelo os suporte.
Escolha um modelo
Falta alterar apenas o valor de model, porque a Nodion usa os seus próprios IDs de modelo. Uma única chamada lista-os e não precisa de chave:
curl https://api.nodion.ai/v1/modelsCada entrada tem o id a enviar como model, o seu kind (chat, embeddings ou rerank), o comprimento do contexto e da saída, o preço por token em USD e EUR, e supported_features como tools, json_mode, structured_outputs ou reasoning. O campo serving indica se os pesos correm na Nodion (hosted) ou se o pedido é encaminhado para um fornecedor (routed).
Os modelos de OCR, voz, imagem e ferramentas não estão nessa lista. O catálogo completo com preços está em AI Inference e no separador Models do dashboard. Os modelos marcados como Preview podem sair do catálogo com pouca antecedência.
Que endpoints existem
Estes são os principais endpoints em api.nodion.ai/v1; a lista completa está na referência da API.
| Endpoint | O que faz | Faturado por |
|---|---|---|
GET /v1/models | Lista os modelos de chat, embeddings e rerank | Gratuito |
POST /v1/chat/completions | Chat, ferramentas, saída estruturada | Tokens de entrada e de saída |
POST /v1/embeddings | Embeddings vetoriais | Tokens de entrada |
POST /v1/rerank | Ordena documentos por relevância para uma consulta | Tokens de entrada |
POST /v1/systemone | System One: decisões tipadas com probabilidades | Tokens de entrada |
POST /v1/ocr | OCR de documentos e imagens | Páginas |
POST /v1/audio/transcriptions, mais um WebSocket em tempo real | Voz para texto | Segundos de áudio |
POST /v1/audio/speech | Texto para voz | Caracteres |
/v1/audio/voices | Lista, cria, lê e elimina vozes clonadas | Gratuito |
POST /v1/images/generations | Geração de imagens | Imagens |
POST /v1/tools/web_search, web_news, web_fetch, web_images, web_videos, web_places, web_maps, web_shopping, web_lens | Ferramentas web | Chamadas; web_search também por página obtida |
O que funciona de forma diferente
- Comprimento da saída: sem
max_tokens, o gateway define esse valor como o comprimento máximo de saída do modelo. Valores superiores são reduzidos a esse máximo. - Utilização em streams: o gateway ativa
stream_options.include_usage, por isso o último chunk traz normalmente a contagem de tokens. - PDF: envie-os inline como bloco de conteúdo
filecom um data URI em base64. As primeiras 20 páginas são convertidas em imagens, por isso é necessário um modelo que aceite imagens como entrada. As referênciasfile_idsão rejeitadas. - Imagens: a geração de imagens devolve apenas
b64_json, sem URLs. - Erros: o formato de erro da OpenAI, com 402 quando o saldo não cobre um pedido e 429 quando é atingido um limite da chave. Cada resposta inclui um cabeçalho
X-Request-IDque pode indicar ao suporte. - Limites: por omissão, 300 pedidos e 2 000 000 tokens por minuto e 10 pedidos simultâneos por chave. Contacte o suporte se precisar de mais.
Privacidade: zero data retention e regiões por projeto
O separador Settings do AI Inference controla a forma como os pedidos de um projeto são servidos:
- permitir ou excluir fornecedores,
- uma lista opcional de regiões permitidas, que restringe as regiões que podem servir o projeto,
- opções de política como zero data retention.
As definições aplicam-se ao projeto e, por isso, abrangem todas as suas chaves. Se nenhuma rota disponível para um modelo corresponder a estas definições, o pedido falha com um erro 503. Mantenha separados os projetos com necessidades de privacidade diferentes, por exemplo um para dados de clientes e outro para experiências internas.
Faturação: saldo pré-pago, ao token
Os gastos com IA saem de um saldo pré-pago, separado da fatura mensal da plataforma. Pode carregá-lo com cartão ou PayPal no separador Billing, ou ativar o carregamento automático.
- O chat é faturado pelos tokens de entrada e de saída ao preço do modelo, e a entrada em cache ao preço de cache quando a rota o reporta.
- Os embeddings, o rerank e o System One são faturados pelos tokens de entrada. O OCR é faturado por página, a conversão de voz em texto por segundo de áudio, a conversão de texto em voz por carácter, as imagens por imagem e as ferramentas web por chamada, sendo o
web_searchfaturado também por cada página que obtém. - Antes de cada chamada, é reservado no saldo um valor igual ao custo máximo do pedido. O pedido é depois liquidado com base na utilização reportada, nunca acima do valor reservado, e o restante é libertado.
- Cada chave pode ter um limite de gastos diário, e pode definir um limite de gastos mensal no separador Billing.
Os preços por modelo estão em AI Inference, não na tabela de preços da plataforma.
Próximos passos
- Todos os endpoints com exemplos, limites e códigos de erro: referência da API de IA.
- Chaves, saldo e separadores do dashboard: documentação do AI Inference.
- Experimente um modelo antes de mudar: o separador Playground executa chat e outros modos. O tráfego do Playground é contabilizado como qualquer outro pedido.
- Prefere que o seu agente de programação gira aplicações e bases de dados? Para isso, use o MCP com uma chave da plataforma, não com uma chave de inferência.
Perguntas frequentes
O SDK da OpenAI funciona com o Nodion AI Inference?
Sim. A API segue o formato da OpenAI, pelo que, nas chamadas suportadas, os SDK oficiais para Python e Node.js funcionam se definir o URL base como https://api.nodion.ai/v1 e usar uma chave de inferência e um ID de modelo da Nodion. Confirme o suporte de endpoints e funcionalidades antes de mover outras chamadas.
Como altero o URL base do SDK da OpenAI para Python?
Passe base_url="https://api.nodion.ai/v1" e a sua chave a OpenAI(), ou defina as variáveis de ambiente OPENAI_BASE_URL e OPENAI_API_KEY, que o SDK lê quando não passa argumentos.
Posso restringir o local onde os meus pedidos de IA são processados?
Sim, por projeto. O separador Settings do AI Inference tem uma lista opcional de regiões permitidas, controlos por fornecedor e uma opção de zero data retention. Se nenhuma rota operacional corresponder a estas definições, o pedido falha com um erro 503.
Como é faturado o Nodion AI Inference?
A partir de um saldo pré-pago que carrega com cartão ou PayPal, separado da fatura da plataforma. O chat é faturado por token de entrada e de saída ao preço do modelo; os outros endpoints faturam por página, segundo de áudio, carácter, imagem ou chamada, e o web_search também por página obtida.