
Cambia a una API compatible con OpenAI con enrutamiento solo en la UE
 Niklas KarolyFundador de Nodion
En resumen
- Nodion AI Inference, en https://api.nodion.ai/v1, sigue el formato de la API de OpenAI, así que para las llamadas compatibles los SDKs oficiales de OpenAI funcionan en cuanto cambias la URL base, la clave de API y el ID del modelo.
- La API cubre chat completions, embeddings, rerank, OCR, voz a texto, texto a voz, generación de imágenes, herramientas web y decisiones de System One.
- Cada proyecto puede restringir qué regiones pueden servir sus peticiones y activar zero data retention en la pestaña Settings de AI Inference.
- El uso se factura por token, o por página, segundo, carácter, imagen o llamada (web_search también por página obtenida), desde un saldo prepago; los modelos y los precios están en AI Inference.
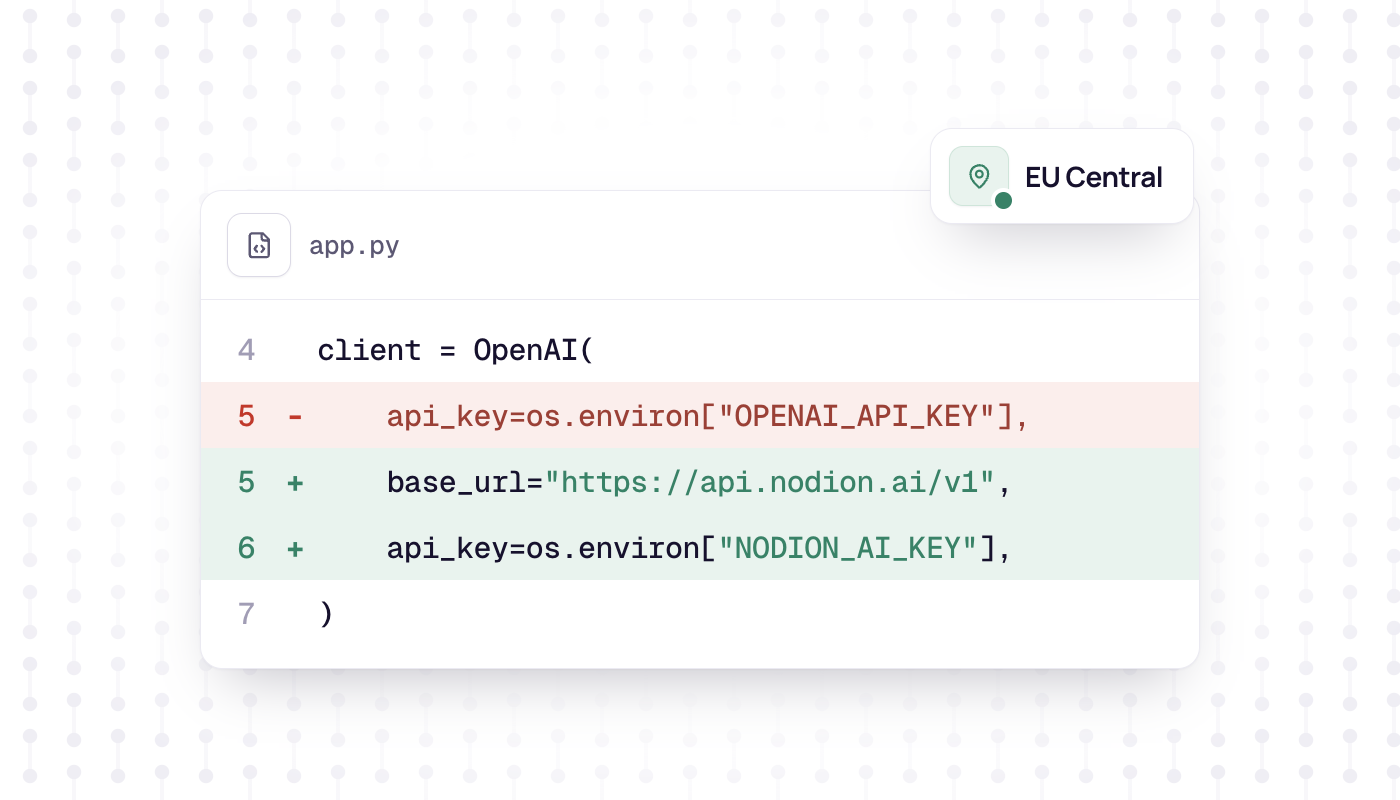
Si tu código ya llama a la API de OpenAI, trasladar a Nodion AI Inference las llamadas compatibles, como chat completions, requiere tres cambios: la URL base, la clave de API y el ID del modelo. La API en https://api.nodion.ai/v1 sigue el formato de OpenAI, así que los SDKs oficiales de OpenAI para Python y Node.js siguen funcionando. Antes de mover otras llamadas, comprueba que los endpoints y las funciones que usas estén soportados.
Nodion AI Inference es un servicio de Nodion GmbH, con sede en Alemania. Se factura por token con cargo a un saldo prepago. Las claves, el uso y los ajustes de privacidad quedan en el mismo proyecto que tu app. Algunos modelos se ejecutan en Nodion; otros se enrutan a un proveedor. Para mantener el procesamiento en la UE y exigir zero data retention, define en el proyecto una lista de regiones permitidas limitada a la UE y la política de zero data retention, como se explica más abajo.
Qué necesitas
- Una cuenta de Nodion y un proyecto. Abre AI Inference en ese proyecto.
- Una clave de inferencia de la pestaña Keys. Las claves de inferencia empiezan por
nodion_ai_y se muestran una sola vez. Las claves de la API de la plataforma Nodion no sirven aquí. - Saldo disponible. Recárgalo con tarjeta o PayPal en la pestaña Billing.
Opción 1: cambia dos variables de entorno
Los dos SDKs de OpenAI leen la URL base y la clave del entorno cuando creas el cliente sin argumentos. Si tu código llama a OpenAI() en Python o a new OpenAI() en Node.js, define estas dos variables, cambia el ID del modelo por uno de Nodion y deja el resto del código como está:
OPENAI_BASE_URL=https://api.nodion.ai/v1
OPENAI_API_KEY=nodion_ai_your_key
Opción 2: cambia los ajustes en el código
Si pasas los ajustes en el código, añade la URL base y cambia la clave. Python:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nodion.ai/v1",
    api_key=os.environ["NODION_AI_KEY"],
)
reply = client.chat.completions.create(
    model="<model>",
    messages=[{"role": "user", "content": "Hello"}],
)
print(reply.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nodion.ai/v1",
  apiKey: process.env.NODION_AI_KEY,
});
const reply = await client.chat.completions.create({
  model: "<model>",
  messages: [{ role: "user", content: "Hello" }],
});
console.log(reply.choices[0].message.content);
Streaming, tool calls, modo JSON y salida estructurada usan las mismas llamadas del SDK que antes, siempre que el modelo los admita.
Elige un modelo
El valor de model es lo único que queda por cambiar, porque Nodion usa sus propios IDs de modelo. Una sola llamada los lista, y no necesita clave:
curl https://api.nodion.ai/v1/modelsCada entrada incluye el id que debes enviar como model, su kind (chat, embeddings o rerank), la longitud de contexto y de salida, el precio por token en USD y EUR, y supported_features como tools, json_mode, structured_outputs o reasoning. El campo serving indica si los pesos se ejecutan en Nodion (hosted) o si la petición se reenvía a un proveedor (routed).
Los modelos de OCR, voz, imagen y herramientas no están en esa lista. El catálogo completo con precios está en AI Inference y en la pestaña Models del dashboard. Los modelos marcados como Preview pueden retirarse del catálogo con poco preaviso.
Qué endpoints hay
Estos son los endpoints principales en api.nodion.ai/v1; la lista completa está en la referencia de la API.
| Endpoint | Qué hace | Se factura por |
|---|---|---|
GET /v1/models | Lista modelos de chat, embeddings y rerank | Gratis |
POST /v1/chat/completions | Chat, herramientas, salida estructurada | Tokens de entrada y salida |
POST /v1/embeddings | Embeddings vectoriales | Tokens de entrada |
POST /v1/rerank | Ordena documentos según una consulta | Tokens de entrada |
POST /v1/systemone | System One: decisiones tipadas con probabilidades | Tokens de entrada |
POST /v1/ocr | OCR de documentos e imágenes | Páginas |
POST /v1/audio/transcriptions, más un WebSocket en tiempo real | Voz a texto | Segundos de audio |
POST /v1/audio/speech | Texto a voz | Caracteres |
/v1/audio/voices | Lista, crea, lee y elimina voces clonadas | Gratis |
POST /v1/images/generations | Generación de imágenes | Imágenes |
POST /v1/tools/web_search, web_news, web_fetch, web_images, web_videos, web_places, web_maps, web_shopping, web_lens | Herramientas web | Llamadas; web_search también por página obtenida |
Qué funciona de otra manera
- Longitud de salida: sin
max_tokens, el gateway lo fija en la longitud máxima de salida del modelo. Los valores mayores se reducen a ese máximo. - Uso en streaming: el gateway activa
stream_options.include_usage, así que el último chunk normalmente lleva el recuento de tokens. - Archivos PDF: envíalos inline como bloque de contenido
filecon un data URI en base64. Las primeras 20 páginas se renderizan como imágenes, así que hace falta un modelo con entrada de imágenes. Las referenciasfile_idse rechazan. - Imágenes: la generación de imágenes solo devuelve
b64_json, sin URLs. - Errores: el formato de error de OpenAI, con 402 cuando el saldo no cubre una petición y 429 cuando se alcanza un límite de la clave. Cada respuesta lleva una cabecera
X-Request-IDque puedes indicar al soporte. - Límites: por defecto, 300 peticiones y 2.000.000 de tokens por minuto y 10 peticiones simultáneas por clave. Si necesitas más, contacta con el soporte.
Privacidad: zero data retention y regiones por proyecto
La pestaña Settings de AI Inference controla cómo se sirven las peticiones de un proyecto:
- permitir o excluir proveedores,
- una lista opcional de regiones permitidas que restringe qué regiones pueden servir al proyecto,
- opciones de política como zero data retention.
Los ajustes se aplican al proyecto, así que cubren todas sus claves. Si ninguna ruta operativa de un modelo los cumple, la petición falla con un 503. Separa los proyectos con distintas necesidades de privacidad, por ejemplo uno para datos de clientes y otro para experimentos internos.
Facturación: saldo prepago, por token
El gasto en IA sale de un saldo prepago, separado de la factura mensual de la plataforma. Lo recargas con tarjeta o PayPal en la pestaña Billing, o activas la recarga automática.
- El chat se factura por tokens de entrada y salida al precio del modelo, y la entrada en caché al precio de caché cuando la ruta lo informa.
- Embeddings, rerank y System One se facturan por tokens de entrada. El OCR se factura por página, la voz a texto por segundo de audio, el texto a voz por carácter, las imágenes por imagen y las herramientas web por llamada;
web_searchse factura además por cada página que obtiene. - Antes de cada llamada, se reserva del saldo un importe que cubre el coste máximo estimado. Después la petición se liquida según el uso informado, nunca por encima de la reserva, y el resto se libera.
- Cada clave puede tener un límite de gasto diario, y puedes fijar un límite de gasto mensual en la pestaña Billing.
Los precios por modelo están en AI Inference, no en la lista de precios de la plataforma.
Siguientes pasos
- Todos los endpoints con ejemplos, límites y códigos de error: Referencia de la API de IA.
- Claves, saldo y pestañas del dashboard: documentación de AI Inference.
- Prueba un modelo antes de cambiar: la pestaña Playground ejecuta chat y otros modos. El tráfico del Playground se mide como cualquier otra petición.
- ¿Prefieres que tu coding agent gestione apps y bases de datos? Para eso está MCP con una clave de la plataforma, no una clave de inferencia.
Preguntas frecuentes
¿Funciona el SDK de OpenAI con Nodion AI Inference?
Sí. La API sigue el formato de OpenAI, así que para las llamadas compatibles los SDKs oficiales de Python y Node.js funcionan si pones la URL base https://api.nodion.ai/v1 y usas una clave de inferencia y un ID de modelo de Nodion. Antes de mover otras llamadas, comprueba qué endpoints y funciones están soportados.
¿Cómo cambio la URL base del SDK de OpenAI para Python?
Pasa base_url="https://api.nodion.ai/v1" y tu clave a OpenAI(), o define las variables de entorno OPENAI_BASE_URL y OPENAI_API_KEY, que el SDK lee cuando no le pasas argumentos.
¿Puedo restringir dónde se procesan mis peticiones de IA?
Sí, por proyecto. La pestaña Settings de AI Inference tiene una lista opcional de regiones permitidas, controles de proveedores y un interruptor de zero data retention. Si ninguna ruta operativa cumple estos ajustes, la petición falla con un 503.
¿Cómo se factura Nodion AI Inference?
Desde un saldo prepago que recargas con tarjeta o PayPal, separado de la factura de la plataforma. El chat se factura por token de entrada y de salida al precio del modelo; los demás endpoints facturan por página, segundo de audio, carácter, imagen o llamada, y web_search también por página obtenida.