Wechsel zu einer OpenAI-kompatiblen API mit Routing nur in der EU
 Niklas KarolyFounder Nodion
Kurz gesagt
- Nodion AI Inference unter https://api.nodion.ai/v1 folgt der OpenAI-API-Form, für unterstützte Calls funktionieren die offiziellen OpenAI-SDKs, nachdem du Base-URL, API-Key und Model-ID änderst.
- Die API deckt Chat Completions, Embeddings, Rerank, OCR, Speech-to-Text, Text-to-Speech, Image Generation, Web-Tools und System-One-Entscheidungen ab.
- Jedes Projekt kann einschränken, welche Regionen seine Requests bedienen dürfen, und Zero Data Retention im Settings-Tab von AI Inference einschalten.
- Nutzung wird pro Token abgerechnet, oder pro Seite, Sekunde, Zeichen, Bild oder Call (web_search auch pro geladener Seite), aus einem Prepaid-Wallet; Modelle und Preise stehen unter AI Inference.
Wenn dein Code schon die OpenAI-API aufruft, brauchst du für unterstützte Calls wie Chat Completions auf Nodion AI Inference drei Änderungen: die Base-URL, den API-Key und die Model-ID. Die API unter https://api.nodion.ai/v1 folgt der OpenAI-Form, die offiziellen OpenAI-SDKs für Python und Node.js bleiben also nutzbar. Prüfe, dass die Endpoints und Features, die du nutzt, unterstützt sind, bevor du andere Calls umziehst.
Nodion AI Inference kommt von der Nodion GmbH in Deutschland, rechnet pro Token aus einem Prepaid-Wallet ab und hält Keys, Nutzung und Privacy-Settings im selben Projekt wie deine App. Manche Modelle laufen auf Nodion, andere werden an einen Provider geroutet. Damit die Verarbeitung in der EU bleibt und Zero Data Retention gilt, setze eine Allowlist nur für EU-Regionen und die Zero-Data-Retention-Policy am Projekt, wie unten gezeigt.
Was du brauchst
- Ein Nodion-Konto und ein Projekt. Öffne AI Inference in diesem Projekt.
- Einen Inference-Key im Tab Keys. Inference-Keys beginnen mit
nodion_ai_und werden einmal angezeigt. Keys für die Nodion-Plattform-API funktionieren hier nicht. - Guthaben im Wallet. Lade es per Karte oder PayPal im Tab Billing auf.
Option 1: Zwei Umgebungsvariablen ändern
Beide OpenAI-SDKs lesen Base-URL und Key aus der Umgebung, wenn du den Client ohne Argumente anlegst. Wenn dein Code OpenAI() in Python oder new OpenAI() in Node.js aufruft, setze diese zwei Variablen, ändere die Model-ID auf ein Nodion-Modell und lass den Rest des Codes, wie er ist:
OPENAI_BASE_URL=https://api.nodion.ai/v1
OPENAI_API_KEY=nodion_ai_your_key
Option 2: Die Settings im Code ändern
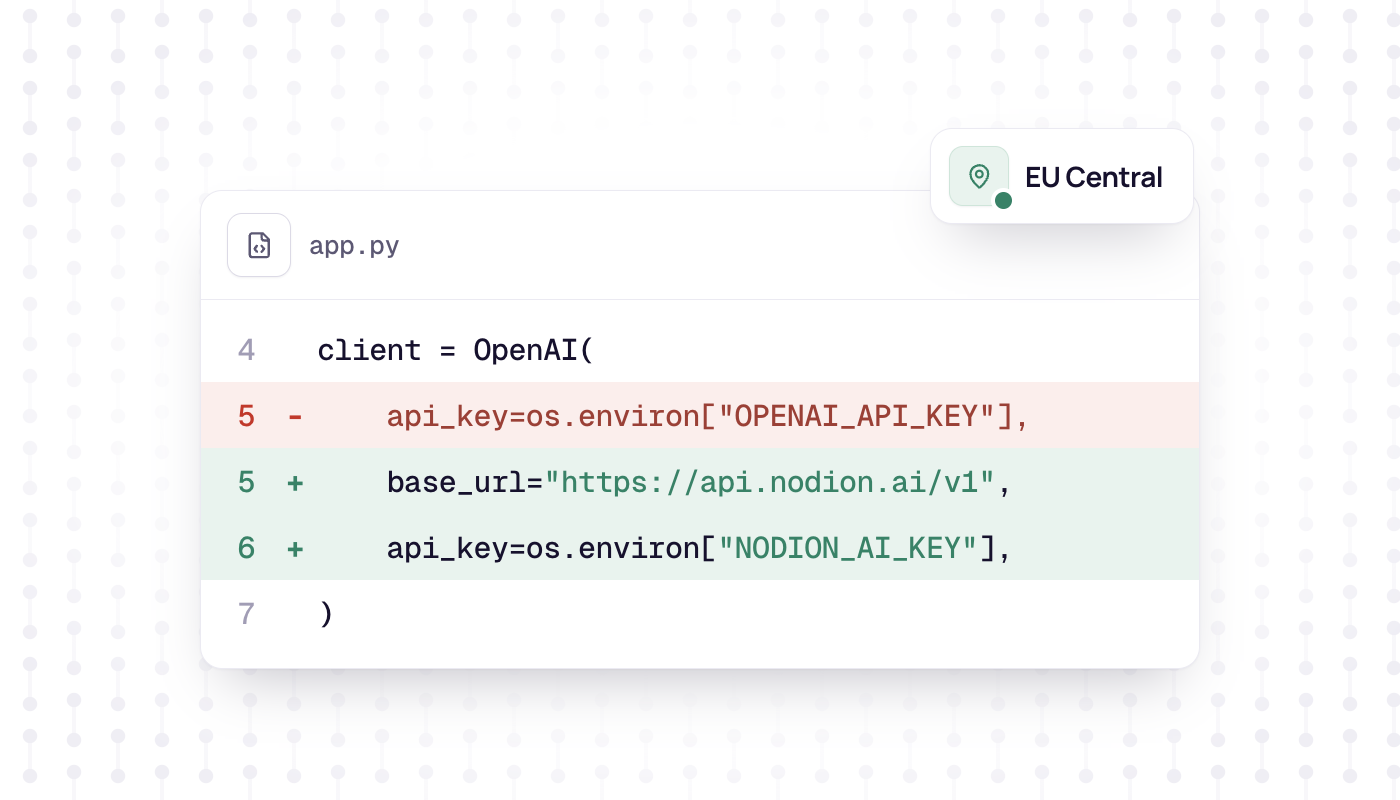
Wenn du die Settings im Code übergibst, ergänze die Base-URL und tausche den Key. Python:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nodion.ai/v1",
    api_key=os.environ["NODION_AI_KEY"],
)
reply = client.chat.completions.create(
    model="<model>",
    messages=[{"role": "user", "content": "Hello"}],
)
print(reply.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nodion.ai/v1",
  apiKey: process.env.NODION_AI_KEY,
});
const reply = await client.chat.completions.create({
  model: "<model>",
  messages: [{ role: "user", content: "Hello" }],
});
console.log(reply.choices[0].message.content);
Streaming, Tool Calls, JSON Mode und Structured Output nutzen dieselben SDK-Calls wie bisher, sofern das Modell sie unterstützt.
Ein Modell wählen
Der Wert model ist das Einzige, das noch zu ändern ist, weil Nodion eigene Model-IDs nutzt. Ein Call listet sie, und er braucht keinen Key:
curl https://api.nodion.ai/v1/modelsJeder Eintrag hat die id, die du als model sendest, sein kind (chat, embeddings oder rerank), Context- und Output-Länge, den Preis pro Token in USD und EUR und supported_features wie tools, json_mode, structured_outputs oder reasoning. Das Feld serving sagt, ob die Weights auf Nodion laufen (hosted) oder der Request an einen Provider weitergeht (routed).
OCR-, Speech-, Image- und Tool-Modelle stehen nicht in dieser Liste. Der volle Katalog mit Preisen liegt unter AI Inference und im Tab Models im Dashboard. Als Preview markierte Modelle können kurzfristig aus dem Katalog fallen.
Welche Endpoints es gibt
Das sind die wichtigsten Endpoints auf api.nodion.ai/v1; die volle Liste steht in der API-Referenz.
| Endpoint | Was er macht | Abrechnung |
|---|---|---|
GET /v1/models | Chat-, Embeddings- und Rerank-Modelle listen | Kostenlos |
POST /v1/chat/completions | Chat, Tools, Structured Output | Input- und Output-Tokens |
POST /v1/embeddings | Vektor-Embeddings | Input-Tokens |
POST /v1/rerank | Dokumente gegen eine Query ranken | Input-Tokens |
POST /v1/systemone | System One: typisierte Entscheidungen mit Wahrscheinlichkeiten | Input-Tokens |
POST /v1/ocr | Dokument- und Bild-OCR | Seiten |
POST /v1/audio/transcriptions, plus ein Realtime-WebSocket | Speech to Text | Audiosekunden |
POST /v1/audio/speech | Text to Speech | Zeichen |
/v1/audio/voices | Geklonte Stimmen listen, anlegen, lesen und löschen | Kostenlos |
POST /v1/images/generations | Bildgenerierung | Bilder |
POST /v1/tools/web_search, web_news, web_fetch, web_images, web_videos, web_places, web_maps, web_shopping, web_lens | Web-Tools | Calls; web_search zusätzlich pro geladener Seite |
Was sich anders verhält
- Output-Länge: ohne
max_tokenssetzt das Gateway sie auf die maximale Output-Länge des Modells. Größere Werte werden darauf gekürzt. - Usage in Streams: das Gateway schaltet
stream_options.include_usageein, der letzte Chunk trägt also in der Regel die Token-Zahlen. - PDFs: sende sie inline als
file-Content-Block mit einer Base64-Data-URI. Die ersten 20 Seiten werden zu Bildern gerendert, das braucht also ein Modell mit Image-Input. Referenzen auffile_idwerden abgelehnt. - Bilder: die Bildgenerierung liefert nur
b64_json, keine URLs. - Fehler: die OpenAI-Fehlerhülle, mit 402, wenn das Wallet einen Request nicht deckt, und 429, wenn ein Key-Limit greift. Jede Response trägt einen Header
X-Request-ID, den du dem Support nennen kannst. - Limits: standardmäßig 300 Requests und 2,000,000 Tokens pro Minute und 10 gleichzeitige Requests pro Key. Melde dich beim Support, wenn du mehr brauchst.
Privacy: Zero Data Retention und Regionen pro Projekt
Der Tab Settings von AI Inference steuert, wie die Requests eines Projekts bedient werden:
- Provider erlauben oder ausschließen,
- eine optionale Region-Allowlist, die einschränkt, welche Regionen das Projekt bedienen dürfen,
- Policy-Schalter wie Zero Data Retention.
Die Settings gelten für das Projekt und damit für jeden Key darin. Passt keine gesunde Route für ein Modell dazu, schlägt der Request mit 503 fehl. Halte Projekte mit unterschiedlichen Privacy-Anforderungen getrennt, zum Beispiel eines für Kundendaten und eines für interne Experimente.
Abrechnung: ein Prepaid-Wallet, pro Token
AI-Ausgaben kommen aus einem Prepaid-Wallet, getrennt von der monatlichen Plattformrechnung. Du lädst es per Karte oder PayPal im Tab Billing auf oder schaltest Auto-Top-up ein.
- Chat wird über Input- und Output-Tokens zum Modellpreis abgerechnet, gecachter Input zum Cache-Preis, wenn die Route ihn meldet.
- Embeddings, Rerank und System One werden über Input-Tokens abgerechnet. OCR pro Seite, Speech to Text pro Audiosekunde, Text to Speech pro Zeichen, Bilder pro Bild und Web-Tools pro Call,
web_searchzusätzlich für jede geladene Seite. - Vor einem Call hält das Wallet eine Obergrenze der Kosten. Der Request rechnet dann mit der gemeldeten Nutzung ab, nie über dem Hold, und der Rest wird freigegeben.
- Jeder Key kann ein tägliches Spend-Limit haben, und im Tab Billing kannst du ein monatliches Spend-Limit setzen.
Preise pro Modell stehen unter AI Inference, nicht auf der Plattform-Preisliste.
Nächste Schritte
- Jeder Endpoint mit Beispielen, Limits und Fehlercodes: AI-API-Referenz.
- Keys, Wallet und die Dashboard-Tabs: AI-Inference-Docs.
- Ein Modell vor dem Wechsel testen: der Tab Playground führt Chat und andere Modi aus. Playground-Traffic wird wie jeder andere Request gemessen.
- Soll dein Coding-Agent Apps und Datenbanken verwalten? Das ist MCP mit einem Plattform-Key, keinem Inference-Key.
Häufige Fragen
Funktioniert das OpenAI-SDK mit Nodion AI Inference?
Ja. Die API folgt der OpenAI-Form, für unterstützte Calls funktionieren die offiziellen Python- und Node.js-SDKs, wenn du die Base-URL auf https://api.nodion.ai/v1 setzt, einen Nodion-Inference-Key und eine Nodion-Model-ID nutzt. Prüfe Endpoint- und Feature-Support, bevor du andere Calls umziehst.
Wie ändere ich die Base-URL des OpenAI-Python-SDKs?
Übergib base_url="https://api.nodion.ai/v1" und deinen Key an OpenAI(), oder setze die Umgebungsvariablen OPENAI_BASE_URL und OPENAI_API_KEY, die das SDK liest, wenn du keine Argumente übergibst.
Kann ich einschränken, wo meine AI-Requests verarbeitet werden?
Ja, pro Projekt. Der Settings-Tab von AI Inference hat eine optionale Region-Allowlist, Provider-Steuerung und einen Schalter für Zero Data Retention. Passt keine gesunde Route zu diesen Settings, schlägt der Request mit 503 fehl.
Wie wird Nodion AI Inference abgerechnet?
Aus einem Prepaid-Wallet, das du per Karte oder PayPal auflädst, getrennt von der Plattformrechnung. Chat wird pro Input- und Output-Token zum Modellpreis abgerechnet; andere Endpoints nach Seite, Audiosekunde, Zeichen, Bild oder Call, web_search zusätzlich pro geladener Seite.