
Zero data retention pour les API de LLM : ce que cela signifie et comment la vérifier
 Niklas KarolyFondateur de Nodion
En bref
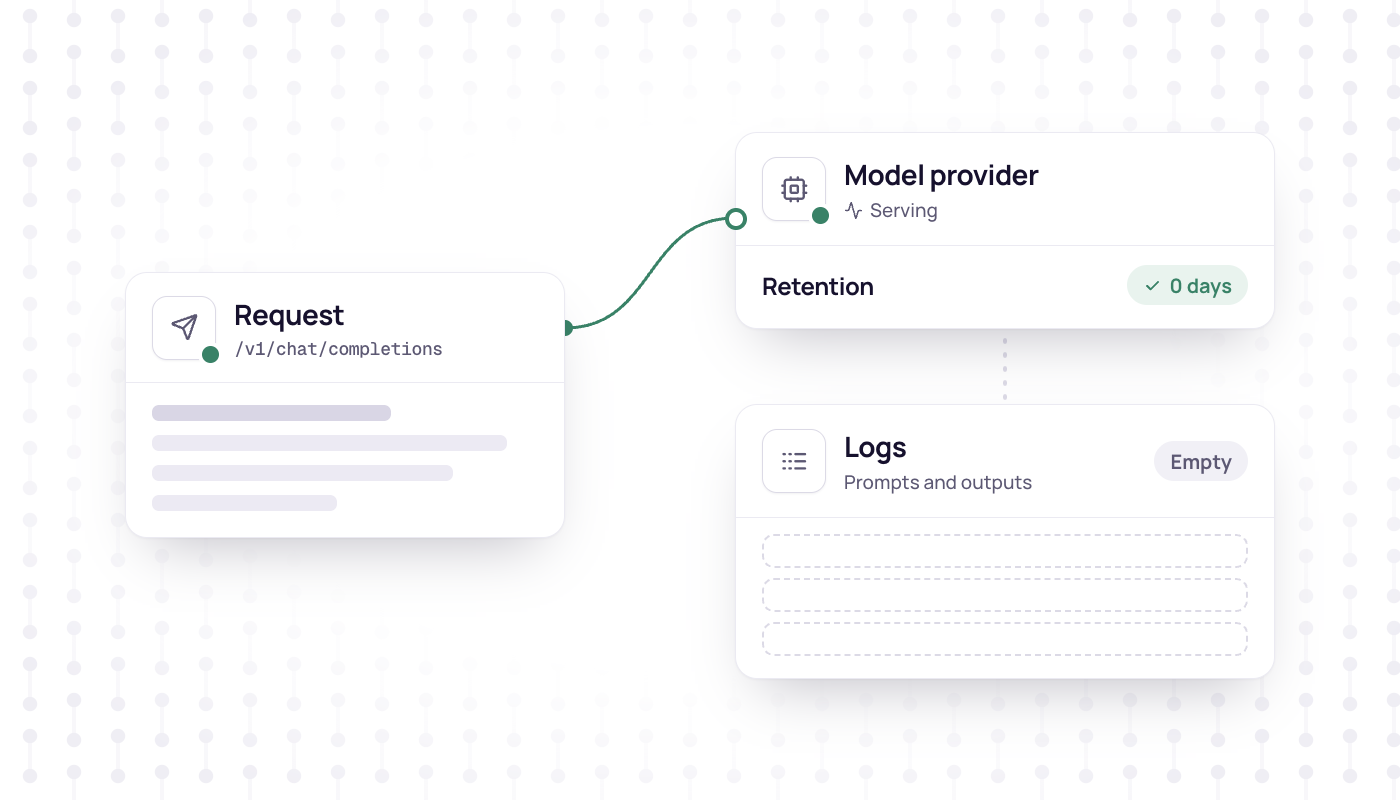
- Nodion AI Gateway route uniquement vers des fournisseurs basés dans l'UE, tous avec zero data retention ; le DPA AI Inference couvre les prompts et les sorties des modèles hébergés par Nodion.
- La zero data retention (ZDR) n'est ni une norme ni un terme juridique : chaque fournisseur d'API de LLM la définit dans sa propre documentation, l'accorde à sa manière et liste ses propres exceptions.
- Par défaut, OpenAI conserve les logs de détection des abus jusqu'à 30 jours, Mistral conserve les entrées et les sorties pendant 30 jours glissants, la politique commerciale d'Anthropic les supprime sous 30 jours, et la Gemini Developer API payante les conserve 55 jours.
- Même avec la ZDR, OpenAI, Anthropic et Mistral excluent des fonctionnalités avec état comme les fichiers et les batchs, et OpenAI et Anthropic peuvent conserver le contenu signalé : vérifiez donc le périmètre, le caching, les métadonnées et la localisation des données pour chaque fournisseur.
La zero data retention (ZDR) signifie, en principe, qu'un fournisseur d'API de LLM ne conserve pas vos prompts ni vos sorties une fois la réponse renvoyée. Il n'existe pourtant pas de définition commune. Chaque fournisseur en donne sa propre définition, fixe ses modalités d'accès et liste ses exceptions. Ci-dessous : ce que les fournisseurs conservent par défaut, comment OpenAI, Anthropic, Google, Mistral, OpenRouter et Azure gèrent la ZDR, et une checklist. Situation en octobre 2026.
Même la formulation diffère : OpenRouter la définit comme le fait qu'un fournisseur ne stocke pas vos données « for any period of time », Anthropic comme le fait de ne pas stocker les prompts ni les réponses « at rest after the API response is returned ».
Ce que les fournisseurs conservent par défaut, et pourquoi
La raison principale est la détection des abus (abuse monitoring) : les prompts et les sorties restent dans des logs pour que les violations des règles d'utilisation puissent être repérées. Les fonctionnalités avec état, comme les fichiers, les batchs ou les agents, conservent les données plus longtemps.
- OpenAI : logs de détection des abus conservés jusqu'à 30 jours, qui peuvent contenir les prompts et les réponses. La Responses API conserve l'état de l'application 30 jours par défaut.
- Anthropic : sa politique commerciale supprime les entrées et sorties de l'API sous 30 jours, avec des exceptions comme un accord ZDR, la Files API, l'application de la Usage Policy ou une obligation légale.
- Mistral : entrées et sorties pendant 30 jours glissants pour la détection des abus, sauf si la ZDR est activée ; les données de l'Agents API jusqu'à la clôture du compte.
- Gemini Developer API : 55 jours sur le niveau payant, pour détecter les violations des règles. Sur le niveau gratuit, Google peut utiliser le contenu pour améliorer ses produits, et des examinateurs humains peuvent le lire.
- Vertex AI (désormais Gemini Enterprise Agent Platform) : selon la classe de modèle et l'accord, cela va des seuls prompts signalés, conservés jusqu'à 90 jours, à l'ensemble des prompts et des réponses, conservés jusqu'à 30 jours.
L'entraînement est une autre question : OpenAI, Anthropic et Google (API payante et Vertex) disent ne pas entraîner leurs modèles sur les données de l'API par défaut ; chez Mistral, la ZDR et le refus de l'entraînement (opt-out) sont des réglages distincts.
Sources, vérifiées en octobre 2026 : OpenAI contrôles des données ; Anthropic conservation, entraînement ; Mistral politique de confidentialité, ZDR ; Google conditions de la Gemini API, règles d'utilisation, détection des abus sur Vertex ; définitions : OpenRouter, Anthropic.
Fournisseur par fournisseur
OpenAI
La ZDR et le Modified Abuse Monitoring (MAM) nécessitent une approbation préalable d'OpenAI. Les deux excluent le contenu client des logs de détection des abus ; la ZDR traite en plus store sur /v1/responses et /v1/chat/completions comme false. Les endpoints non éligibles à la ZDR, comme les fichiers, les vector stores, les assistants, les conversations, les batchs et le fine-tuning, peuvent toujours stocker un état. Les images et les fichiers signalés pour suspicion de contenu pédocriminel (CSAM) sont conservés pour examen, même sous ZDR.
Anthropic
La ZDR se met en place avec l'équipe commerciale, par organisation. Elle couvre les API Messages et Token Counting pour les fonctionnalités éligibles. Le traitement par lots (29 jours), la Files API, l'outil d'exécution de code (données du conteneur jusqu'à 30 jours), le connecteur MCP et la Console en sont exclus, et les modèles désignés comme Covered Models exigent une conservation de 30 jours. L'API ne bloque pas les fonctionnalités non éligibles : en utiliser une fait sortir les données concernées de l'accord ZDR. Le contenu signalé peut être conservé jusqu'à 2 ans.
Google : Gemini Developer API et Vertex AI
La page ZDR de Google pour la Gemini Developer API l'indique elle-même : « If your workload requires guaranteed zero data retention or enterprise data processing agreements, use Vertex AI. » Google recommande donc Vertex AI si vous exigez une garantie de zero data retention ou un accord de traitement des données d'entreprise. Sur Vertex, la ZDR est une série d'étapes que vous effectuez vous-même : laisser la journalisation des requêtes et des réponses désactivée, mettre store à false sur l'Interactions API et, si aucune donnée ne doit être stockée au repos, désactiver le cache durable par projet. Le grounding avec Google Search conserve des données jusqu'à 3 jours et ne peut pas être désactivé ; Google recommande à la place Web Grounding for Enterprise.
Mistral
Mistral (Paris) propose la ZDR uniquement en paiement à l'usage (pay-as-you-go) et uniquement pour les appels d'API sans état, comme les chat completions, les embeddings, l'OCR et l'audio. Les agents, les fichiers de batch, les conversations, les bibliothèques (libraries) et /v1/files sont exclus. Vous en faites la demande via le Help Center en expliquant vos raisons ; Mistral reste libre de l'accorder, et la ZDR approuvée apparaît dans le panneau d'administration. Les conditions commerciales de Mistral lui permettent d'entraîner ses modèles sur les données des modèles Labs ou Preview, même si vous avez refusé l'entraînement par ailleurs, y compris via la ZDR.
OpenRouter
Chez OpenRouter, la ZDR est un filtre de routage à activer (opt-in), par compte, groupe de modèles, guardrail ou requête : les requêtes ne vont qu'aux endpoints dont OpenRouter a enregistré la politique comme zero retention, et une politique peu claire est traitée comme si le fournisseur conservait les données et s'en servait pour l'entraînement. Elle ne couvre pas les plugins et les outils comme la recherche web, et OpenRouter ne considère pas le cache en mémoire comme de la conservation. OpenRouter lui-même ne stocke les prompts et les réponses que si vous l'activez ou si un contenu est signalé pour suspicion de contenu pédocriminel (CSAM), et il conserve des métadonnées comme le nombre de tokens et la latence. Sa page ZDR annonce un contrôle CSAM de toutes les requêtes, trafic ZDR compris, à partir du 27 octobre 2026. Dans les offres Business et Enterprise, eu.openrouter.ai traite les prompts et les complétions dans la région.
Azure OpenAI
Pour les modèles Azure OpenAI (désormais « Foundry Models sold by Azure »), les prompts et les complétions ne sont pas accessibles à OpenAI et ne servent pas à entraîner des modèles de fondation sans autorisation. Le contenu signalé conservé pour un examen humain est stocké dans la zone géographique de votre ressource. Désactiver cela (modified abuse monitoring) nécessite une approbation et est réservé aux clients suivis par une équipe de compte Microsoft ou inscrits à un programme éligible.
Sources : OpenAI contrôles des données ; Anthropic ZDR ; Google ZDR de la Gemini API, ZDR de Vertex ; Mistral ZDR, conditions commerciales ; OpenRouter ZDR, collecte des données, journalisation chez les fournisseurs ; Azure confidentialité des données, accès limité.
Mise en cache des prompts
Les caches conservent brièvement des parties d'un prompt pour accélérer les requêtes suivantes. La durée de vie, le stockage et la position vis-à-vis de la ZDR varient :
| Fournisseur | Durée de vie | Où | Position sur la ZDR |
|---|---|---|---|
| OpenAI | De quelques minutes à 24 heures, selon le modèle et le réglage | Tenseurs KV, aussi dans le stockage local du GPU | « compatible with Zero Data Retention » |
| Anthropic | 5 minutes, renouvelées à chaque utilisation ; 1 heure en option | Représentations KV et empreintes de hachage en mémoire | Éligible à la ZDR |
| Vertex AI | Jusqu'à 24 heures, cache en mémoire et cache durable tous deux activés par défaut | Cache durable au repos | La mise en cache durable, voire toute mise en cache, peut être désactivée par projet |
| Gemini Developer API | Implicite : 24 heures, explicite : selon votre TTL | Implicite : en RAM uniquement | L'implicite est compatible ; évitez cached_content |
| OpenRouter | Chez le fournisseur | Caches en mémoire des fournisseurs | Pas considéré comme de la conservation |
OpenAI, Anthropic et Google isolent les caches par organisation ou par projet.
Sources : OpenAI, Anthropic, Vertex, Gemini API, OpenRouter.
Localisation des données dans l'UE
La localisation est une promesse distincte de la ZDR, et chaque fournisseur l'organise différemment :
- OpenAI : la région Europe (EEE et Suisse) exige une approbation pour le MAM ou la ZDR et un avenant Modified Retention. Les données système, comme les données de compte, les métadonnées et les données d'utilisation, en sont exclues.
- Anthropic : la documentation sur la résidence des données liste
global(par défaut) etuspour l'inférence, etuscomme seule zone géographique pour les workspaces. - Mistral : l'endpoint par défaut ne prend aucun engagement sur le lieu de l'inférence.
api.eu.mistral.aitraite dans l'UE, sans fonctionnalités avec état ; les métadonnées du control plane peuvent être traitées hors de la région. - Azure : les déploiements Standard traitent les données dans la zone géographique choisie, les déploiements DataZone dans des États membres de l'UE, les déploiements Global dans n'importe quelle zone géographique.
- Gemini Developer API : les données « may be stored transiently or cached in any country » où Google dispose d'installations.
Sources : OpenAI, Anthropic, Mistral, Azure, Gemini API.
Ce que dit le RGPD
Le RGPD n'utilise pas le terme ZDR, mais plusieurs articles du règlement (UE) 2016/679 s'appliquent :
- Art. 5, par. 1, c), minimisation des données : uniquement les données à caractère personnel nécessaires à la finalité.
- Art. 5, par. 1, e), limitation de la conservation : pas plus longtemps que nécessaire.
- Art. 25, par. 2, protection des données par défaut, qui inclut explicitement la durée de conservation.
- Art. 28 : les sous-traitants doivent présenter des garanties suffisantes, les sous-traitants ultérieurs nécessitent une autorisation, et le contrat (DPA) fixe la durée, les instructions et la suppression.
- Art. 44 : transferts vers des pays tiers uniquement aux conditions du chapitre V, transferts ultérieurs compris.
Une conservation courte ou nulle signifie moins de données personnelles stockées moins longtemps ; les durées de conservation ont leur place dans le DPA ; des fournisseurs ou des sous-traitants ultérieurs situés hors de l'EEE font entrer en jeu le chapitre V. Il s'agit d'informations de contexte, pas d'un conseil juridique.
Checklist
- Conservation par défaut : combien de jours, dans quel but ?
- Logs de détection des abus : toujours ou seulement en cas de signalement, examen humain, possibilité de refus (opt-out) ?
- Comment la ZDR est accordée et appliquée : approbation, configuration ou filtre de routage ? L'API bloque-t-elle les fonctionnalités non éligibles ?
- Périmètre : quels endpoints sont couverts, lesquels sont exclus (fichiers, batch, agents, fine-tuning) ?
- Modèles : un modèle exige-t-il une conservation ?
- Mise en cache des prompts : durée de vie, mémoire ou disque, peut-on le désactiver ?
- Entraînement : réglages par défaut pour l'API payante, les niveaux gratuits, le feedback et les modèles en preview.
- Contenu signalé et obligations de conservation à des fins juridiques (legal holds).
- Métadonnées et logs : nombre de tokens, latence, adresses IP, données de compte.
- Localisation des données : région d'inférence et de stockage, par défaut ou sur activation (opt-in), exclusions.
- Sous-traitants ultérieurs : liste publiée, DPA selon l'art. 28, mécanisme de transfert du chapitre V.
- Outils tiers : recherche web, exécution de code, stockage de fichiers, serveurs MCP et plugins.
- Preuve : visible dans la console, écrite dans le contrat, ou seulement promise ?
L'approche de Nodion
Nodion AI Gateway (https://api.nodion.ai/v1) route uniquement vers des fournisseurs basés dans l'UE, tous avec zero data retention. Vous n'avez besoin d'aucun compte chez ces fournisseurs : chaque requête passe par Nodion avec votre clé d'API Nodion, et vous autorisez ou excluez des fournisseurs dans les paramètres IA du projet. Quelques points de la checklist :
- Responses API : Nodion ne stocke aucune réponse.
storeest ignoré, et il n'y a niprevious_response_idniGET /v1/responses/{id}. - DPA : le DPA AI Inference couvre les prompts et les sorties uniquement pour les modèles hébergés par Nodion. Les fournisseurs vers lesquels les requêtes sont routées n'en relèvent pas.
- AI Tools : la recherche web, les actualités et fetch ne relèvent pas de ce DPA, et ce qui est dit plus haut sur la zero data retention concerne les fournisseurs de modèles, pas ces outils.
- Métadonnées : pour les modèles hébergés par Nodion, le DPA liste les métadonnées opérationnelles conservées pour la facturation et la sécurité : horodatages, ID de requête, modèle, statut, nombre de tokens, latence et montant.
Pour aller plus loin : modèles et fournisseurs sur AI Inference, clés et paramètres dans la documentation, offres sur AI Coding Plans, ainsi que les comparatifs des alternatives à OpenRouter et des offres de code IA.
Sources : documentation AI Inference, référence de l'API d'IA : Responses, DPA AI Inference, § 1 et § 4.
Questions fréquentes
Quelle API de LLM propose la zero data retention dans l'UE ?
Nodion AI Gateway route uniquement vers des fournisseurs basés dans l'UE, tous avec zero data retention, et vous appelez tous les modèles avec une seule clé d'API Nodion. Mistral propose la ZDR en paiement à l'usage pour les appels sans état, après approbation, ainsi qu'un endpoint UE à activer (opt-in) ; la région Europe d'OpenAI exige une approbation pour le Modified Abuse Monitoring ou la ZDR.
Que signifie la zero data retention pour une API de LLM ?
Au fond, que le fournisseur ne conserve pas vos prompts ni vos sorties une fois la réponse renvoyée. Il n'existe pas de définition commune : chaque fournisseur fixe son propre périmètre et ses exceptions, comme les fonctionnalités avec état, les caches et le contenu signalé.
Le prompt caching remet-il en cause la zero data retention ?
OpenAI, Anthropic et la Gemini Developer API considèrent leurs caches de courte durée comme compatibles avec la ZDR, et OpenRouter ne compte pas le cache en mémoire comme de la conservation. Sur Vertex AI, le cache durable stocke les données au repos jusqu'à 24 heures, sauf si vous le désactivez par projet.
Le RGPD impose-t-il la zero data retention ?
Le RGPD n'utilise pas ce terme. Il exige la minimisation des données et la limitation de la conservation (art. 5), la protection des données par défaut (art. 25) et un contrat de sous-traitance (art. 28), et une conservation courte ou nulle aide à respecter ces exigences. Ceci n'est pas un conseil juridique.