
Zero data retention w API LLM: co oznacza i jak to sprawdzić
 Niklas KarolyZałożyciel Nodion
W skrócie
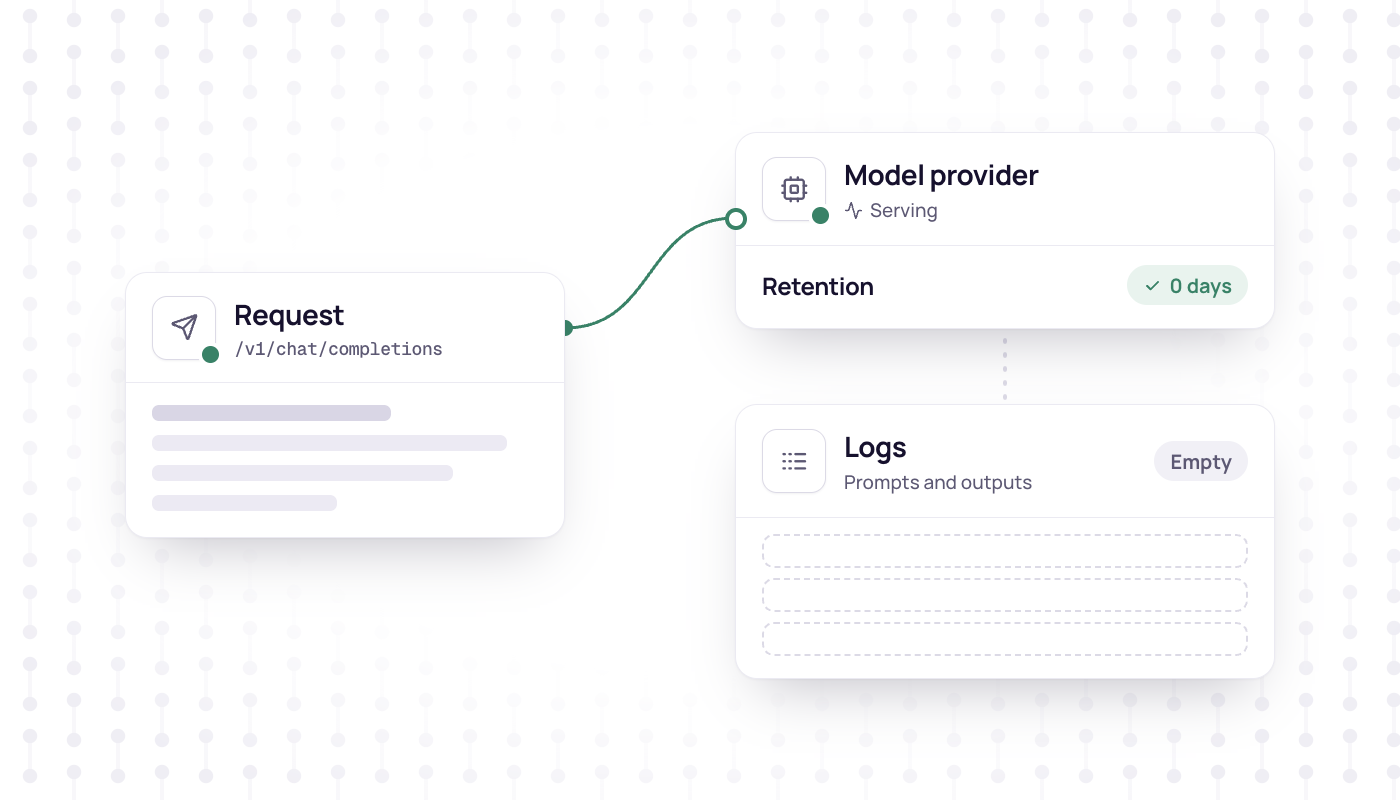
- Nodion AI Gateway kieruje żądania wyłącznie do dostawców z siedzibą w UE, z których wszyscy stosują zero data retention; DPA AI Inference obejmuje prompty i dane wyjściowe modeli hostowanych przez Nodion.
- Zero data retention (ZDR) nie jest standardem ani pojęciem prawnym: każdy dostawca API LLM definiuje je we własnej dokumentacji, przyznaje na własnych zasadach i wymienia własne wyjątki.
- Domyślnie OpenAI przechowuje logi wykrywania nadużyć do 30 dni, Mistral przechowuje dane wejściowe i wyjściowe przez kroczące 30 dni, polityka komercyjna Anthropic przewiduje ich usunięcie w ciągu 30 dni, a płatne Gemini Developer API przechowuje je przez 55 dni.
- Nawet przy ZDR OpenAI, Anthropic i Mistral wyłączają funkcje stanowe, takie jak pliki i batche, a OpenAI i Anthropic mogą zachować oznaczone treści, więc u każdego dostawcy sprawdź zakres, caching, metadane i lokalizację danych.
Zero data retention (ZDR) oznacza w przybliżeniu, że dostawca API LLM nie przechowuje Twoich promptów ani danych wyjściowych po zwróceniu odpowiedzi. Nie ma jednak jednej wspólnej definicji. Każdy dostawca określa własne zasady przyznawania ZDR i własne wyjątki. Poniżej omawiamy, co dostawcy przechowują domyślnie i jak OpenAI, Anthropic, Google, Mistral, OpenRouter oraz Azure podchodzą do ZDR. Na końcu znajdziesz listę kontrolną. Stan na październik 2026.
Różni się nawet samo sformułowanie: OpenRouter definiuje ZDR jako sytuację, w której dostawca nie przechowuje Twoich danych „for any period of time” (przez jakikolwiek czas), a Anthropic jako nieprzechowywanie promptów ani odpowiedzi „at rest after the API response is returned” (w spoczynku po zwróceniu odpowiedzi API).
Co dostawcy przechowują domyślnie i dlaczego
Głównym powodem jest wykrywanie nadużyć (abuse monitoring): prompty i dane wyjściowe trafiają do logów, aby można było wykrywać naruszenia zasad korzystania. Funkcje stanowe, takie jak pliki, przetwarzanie wsadowe czy agenci, przechowują dane dłużej.
- OpenAI: logi wykrywania nadużyć do 30 dni, które mogą zawierać prompty i odpowiedzi. Responses API domyślnie przechowuje stan aplikacji przez 30 dni.
- Anthropic: polityka komercyjna przewiduje usuwanie danych wejściowych i wyjściowych API w ciągu 30 dni, z wyjątkami takimi jak umowa ZDR, Files API, egzekwowanie Usage Policy lub wymogi prawa.
- Mistral: dane wejściowe i wyjściowe przez kroczące 30 dni na potrzeby wykrywania nadużyć, chyba że ZDR jest włączone; dane Agents API do momentu zamknięcia konta.
- Gemini Developer API: 55 dni w płatnym planie na wykrywanie naruszeń zasad. W bezpłatnym planie Google może wykorzystywać treści do ulepszania swoich produktów, a osoby weryfikujące mogą je czytać.
- Vertex AI (obecnie Gemini Enterprise Agent Platform): zależnie od klasy modelu i umowy od samych oznaczonych promptów, przechowywanych do 90 dni, po wszystkie prompty i odpowiedzi, przechowywane do 30 dni.
Trenowanie to osobna kwestia: OpenAI, Anthropic i Google (płatne API i Vertex) deklarują, że domyślnie nie trenują modeli na danych z API; w przypadku Mistral ZDR i rezygnacja z trenowania (opt-out) to osobne ustawienia.
Źródła, sprawdzone w październiku 2026: OpenAI kontrola danych; Anthropic przechowywanie, trenowanie; Mistral polityka prywatności, ZDR; Google warunki Gemini API, zasady korzystania, wykrywanie nadużyć w Vertex; definicje: OpenRouter, Anthropic.
Dostawca po dostawcy
OpenAI
ZDR i Modified Abuse Monitoring (MAM) wymagają wcześniejszej zgody OpenAI. Oba wyłączają treści klienta z logów wykrywania nadużyć; ZDR dodatkowo traktuje store w /v1/responses i /v1/chat/completions jako false. Endpointy nieobjęte ZDR, takie jak pliki, vector stores, asystenci, konwersacje, batche i fine-tuning, nadal mogą przechowywać stan. Obrazy i pliki oznaczone jako potencjalne CSAM (materiały przedstawiające seksualne wykorzystywanie dzieci) są zachowywane do weryfikacji nawet przy ZDR.
Anthropic
ZDR ustala się z działem sprzedaży, osobno dla każdej organizacji. Obejmuje Messages API i Token Counting API w zakresie funkcji, które się kwalifikują. Poza nim są przetwarzanie wsadowe (29 dni), Files API, narzędzie do wykonywania kodu (dane kontenera do 30 dni), konektor MCP i Console, a modele oznaczone jako Covered Models wymagają przechowywania przez 30 dni. API nie blokuje funkcji nieobjętych ZDR: użycie którejś z nich wyprowadza te dane poza ustalenia ZDR. Oznaczone treści mogą być przechowywane do 2 lat.
Google: Gemini Developer API i Vertex AI
Strona Google o ZDR dla Gemini Developer API mówi wprost: „If your workload requires guaranteed zero data retention or enterprise data processing agreements, use Vertex AI.” Jeśli więc potrzebujesz gwarantowanego zero data retention albo firmowych umów o przetwarzaniu danych, Google odsyła Cię do Vertex AI. W Vertex ZDR to zestaw kroków, które wykonujesz samodzielnie: pozostaw logowanie żądań i odpowiedzi wyłączone, ustaw store na false w Interactions API, a jeśli żadne dane nie mogą być przechowywane w spoczynku (at rest), wyłącz trwały cache dla projektu. Grounding with Google Search przechowuje dane do 3 dni i nie da się go wyłączyć; Google zaleca zamiast niego Web Grounding for Enterprise.
Mistral
Mistral (Paryż) oferuje ZDR tylko w modelu pay-as-you-go i tylko dla bezstanowych wywołań API, takich jak chat completions, embeddingi, OCR i audio. Wyłączone są agenci, pliki batch, konwersacje, biblioteki (libraries) i /v1/files. O ZDR prosisz przez Help Center, podając uzasadnienie; Mistral decyduje według własnego uznania, a zatwierdzone ZDR widać w panelu administracyjnym. Warunki komercyjne Mistral pozwalają mu trenować modele na danych z modeli Labs lub Preview, nawet jeśli gdzie indziej wyłączono trenowanie (opt-out), także przez ZDR.
OpenRouter
W OpenRouter ZDR to filtr routingu włączany na życzenie (opt-in) dla konta, grupy modeli, guardrailu lub pojedynczego żądania. Żądania trafiają tylko do endpointów, których politykę OpenRouter oznaczył jako zero retention; niejasną politykę traktuje się tak, jakby dostawca przechowywał dane i trenował na nich modele. ZDR nie obejmuje pluginów ani narzędzi, takich jak wyszukiwanie w sieci, a OpenRouter nie uznaje cache w pamięci za przechowywanie. Sam OpenRouter przechowuje prompty i odpowiedzi tylko wtedy, gdy się na to zgodzisz (opt-in) albo gdy treść zostanie oznaczona jako potencjalne CSAM, i zachowuje metadane, takie jak liczba tokenów i opóźnienie. Jego strona o ZDR zapowiada skanowanie wszystkich żądań pod kątem CSAM, łącznie z ruchem ZDR, od 27 października 2026. W planach Business i Enterprise eu.openrouter.ai przetwarza prompty i odpowiedzi (completions) w obrębie regionu.
Azure OpenAI
W przypadku modeli Azure OpenAI (obecnie „Foundry Models sold by Azure”) prompty i odpowiedzi (completions) nie są dostępne dla OpenAI i bez zgody nie służą do trenowania modeli bazowych (foundation models). Oznaczone treści zatrzymane do weryfikacji przez ludzi są przechowywane w obszarze geograficznym Twojego zasobu. Wyłączenie tego (modified abuse monitoring) wymaga zgody i jest dostępne tylko dla klientów, którymi opiekuje się zespół Microsoft (account team), lub uczestników kwalifikującego się programu.
Źródła: OpenAI kontrola danych; Anthropic ZDR; Google ZDR w Gemini API, ZDR w Vertex; Mistral ZDR, warunki komercyjne; OpenRouter ZDR, zbieranie danych, logowanie u dostawców; Azure prywatność danych, ograniczony dostęp.
Prompt caching
Cache krótko przechowuje fragmenty promptu, aby kolejne żądania były szybsze. Czas życia, miejsce przechowywania i stanowisko wobec ZDR są różne:
| Dostawca | Czas życia | Gdzie | Stanowisko wobec ZDR |
|---|---|---|---|
| OpenAI | Od minut do 24 godzin, zależnie od modelu i ustawienia | Tensory KV, także w lokalnej pamięci GPU | „compatible with Zero Data Retention” (zgodny z ZDR) |
| Anthropic | 5 minut, odnawiane przy każdym użyciu; opcjonalnie 1 godzina | Reprezentacje KV i hashe w pamięci | Kwalifikuje się do ZDR |
| Vertex AI | Do 24 godzin, cache w pamięci i trwały cache są domyślnie włączone | Trwały cache w spoczynku | Trwały cache albo cały caching można wyłączyć dla projektu |
| Gemini Developer API | Niejawny: 24 godziny, jawny: według Twojego TTL | Niejawny: tylko w RAM | Niejawny jest zgodny; unikaj cached_content |
| OpenRouter | U dostawcy | Cache w pamięci u dostawców | Nie jest uznawany za przechowywanie |
OpenAI, Anthropic i Google izolują cache dla każdej organizacji lub projektu.
Źródła: OpenAI, Anthropic, Vertex, Gemini API, OpenRouter.
Lokalizacja danych w UE
Lokalizacja danych to osobna kwestia niż ZDR, a każdy dostawca rozwiązuje ją inaczej:
- OpenAI: region Europa (EOG i Szwajcaria) wymaga zgody na MAM lub ZDR oraz aneksu Modified Retention. Dane systemowe, takie jak dane konta, metadane i dane o użyciu, są z tego wyłączone.
- Anthropic: dokumentacja rezydencji danych wymienia
global(domyślnie) iusdla inferencji orazusjako jedyny obszar geograficzny dla przestrzeni roboczych (workspaces). - Mistral: domyślny endpoint nie daje żadnych zobowiązań co do miejsca inferencji.
api.eu.mistral.aiprzetwarza dane w UE, bez funkcji stanowych; metadane warstwy sterowania (control plane) mogą być przetwarzane poza regionem. - Azure: wdrożenia Standard przetwarzają dane w wybranym obszarze geograficznym, wdrożenia DataZone w państwach członkowskich UE, a wdrożenia Global w dowolnym obszarze geograficznym.
- Gemini Developer API: dane „may be stored transiently or cached in any country” (mogą być przejściowo przechowywane lub buforowane w dowolnym kraju), w którym Google ma infrastrukturę.
Źródła: OpenAI, Anthropic, Mistral, Azure, Gemini API.
Co mówi RODO
RODO nie używa pojęcia ZDR, ale zastosowanie ma kilka artykułów rozporządzenia (UE) 2016/679:
- Art. 5 ust. 1 lit. c), minimalizacja danych: tylko tyle danych osobowych, ile wymaga cel.
- Art. 5 ust. 1 lit. e), ograniczenie przechowywania: nie dłużej, niż jest to niezbędne.
- Art. 25 ust. 2, domyślna ochrona danych, wyraźnie obejmująca okres przechowywania.
- Art. 28: podmioty przetwarzające muszą zapewniać wystarczające gwarancje, dalsze podmioty przetwarzające wymagają zgody, a umowa powierzenia przetwarzania danych (DPA) określa czas trwania, polecenia i usunięcie danych.
- Art. 44: przekazywanie do państw trzecich tylko na warunkach rozdziału V, łącznie z dalszym przekazywaniem.
Krótki lub zerowy okres przechowywania oznacza mniej danych osobowych przechowywanych przez krótszy czas. Okresy przechowywania powinny być określone w DPA. Jeśli dostawcy lub dalsze podmioty przetwarzające znajdują się poza EOG, zastosowanie ma rozdział V. To informacje ogólne, a nie porada prawna.
Checklista
- Domyślne przechowywanie: ile dni i w jakim celu?
- Logi nadużyć: zawsze czy tylko po oznaczeniu, weryfikacja przez ludzi, możliwość opt-out?
- Jak ZDR jest przyznawane i egzekwowane: zgoda, konfiguracja czy filtr routingu? Czy API blokuje funkcje nieobjęte ZDR?
- Zakres: które endpointy są objęte, a które wyłączone (pliki, batch, agenci, fine-tuning)?
- Modele: czy któryś model wymaga przechowywania danych?
- Prompt caching: czas życia, pamięć czy dysk, czy można go wyłączyć?
- Trenowanie: ustawienia domyślne dla płatnego API, bezpłatnych planów, feedbacku i modeli w wersji preview.
- Oznaczone treści i obowiązek zachowania danych do celów prawnych (legal hold).
- Metadane i logi: liczba tokenów, opóźnienie, adresy IP, dane konta.
- Lokalizacja danych: region inferencji i przechowywania, domyślnie czy opt-in, wyłączenia.
- Dalsze podmioty przetwarzające: opublikowana lista, DPA na podstawie art. 28, mechanizm przekazywania z rozdziału V.
- Narzędzia zewnętrzne: wyszukiwanie w sieci, wykonywanie kodu, przechowywanie plików, serwery MCP i pluginy.
- Dowód: widoczne w konsoli, zapisane w umowie czy tylko obiecane?
Jak robi to Nodion
Nodion AI Gateway (https://api.nodion.ai/v1) kieruje żądania wyłącznie do dostawców z siedzibą w UE, z których wszyscy działają z zero data retention. Nie potrzebujesz konta u tych dostawców: każde żądanie przechodzi przez Nodion z Twoim kluczem API Nodion, a dostawców dopuszczasz lub wykluczasz w ustawieniach AI projektu. Kilka punktów z checklisty:
- Responses API: Nodion nie przechowuje żadnych odpowiedzi.
storejest ignorowane i nie ma aniprevious_response_id, aniGET /v1/responses/{id}. - DPA: DPA AI Inference obejmuje prompty i dane wyjściowe wyłącznie w przypadku modeli hostowanych przez Nodion. Dostawcy, do których kierowane są żądania, nie są nią objęci.
- AI Tools: wyszukiwanie w sieci, wiadomości (news) i fetch nie są objęte umową DPA, a powyższe stwierdzenie o zero data retention dotyczy dostawców modeli, nie tych narzędzi.
- Metadane: w przypadku modeli hostowanych przez Nodion DPA wymienia metadane operacyjne przechowywane na potrzeby rozliczeń i bezpieczeństwa: znaczniki czasu, identyfikatory żądań, model, status, liczbę tokenów, opóźnienie i kwotę.
Więcej: modele i dostawcy na stronie AI Inference, klucze i ustawienia w dokumentacji, plany na stronie AI Coding Plans oraz porównania alternatyw dla OpenRouter i planów AI do kodowania.
Źródła: dokumentacja AI Inference, dokumentacja referencyjna AI API: Responses, DPA AI Inference, § 1 i § 4.
Najczęściej zadawane pytania
Które API LLM oferuje zero data retention w UE?
Nodion AI Gateway kieruje żądania wyłącznie do dostawców z siedzibą w UE, z których wszyscy stosują zero data retention, a każdy model wywołujesz jednym kluczem API Nodion. Mistral po zatwierdzeniu oferuje ZDR w modelu pay-as-you-go dla wywołań bezstanowych, a także endpoint w UE włączany na życzenie (opt-in); region Europa w OpenAI wymaga zgody na Modified Abuse Monitoring lub ZDR.
Co oznacza zero data retention w przypadku API LLM?
Oznacza to, że dostawca nie przechowuje Twoich promptów ani danych wyjściowych po zwróceniu odpowiedzi. Nie ma wspólnej definicji: każdy dostawca sam ustala zakres i wyjątki, takie jak funkcje stanowe, cache i oznaczone treści.
Czy prompt caching narusza zero data retention?
OpenAI, Anthropic i Gemini Developer API uznają swoje krótkotrwałe cache za zgodne z ZDR, a OpenRouter nie traktuje cache w pamięci jako przechowywania. W Vertex AI trwały cache przechowuje dane w spoczynku do 24 godzin, chyba że wyłączysz go dla projektu.
Czy RODO wymaga zero data retention?
RODO nie używa tego pojęcia. Wymaga minimalizacji danych i ograniczenia przechowywania (art. 5), domyślnej ochrony danych (art. 25) oraz umowy powierzenia przetwarzania danych (art. 28), a krótkie lub zerowe przechowywanie pomaga spełnić te wymogi. To nie jest porada prawna.