Zero Data Retention bei LLM-APIs: was es heißt und wie du es prüfst
 Niklas KarolyFounder Nodion
Kurz gesagt
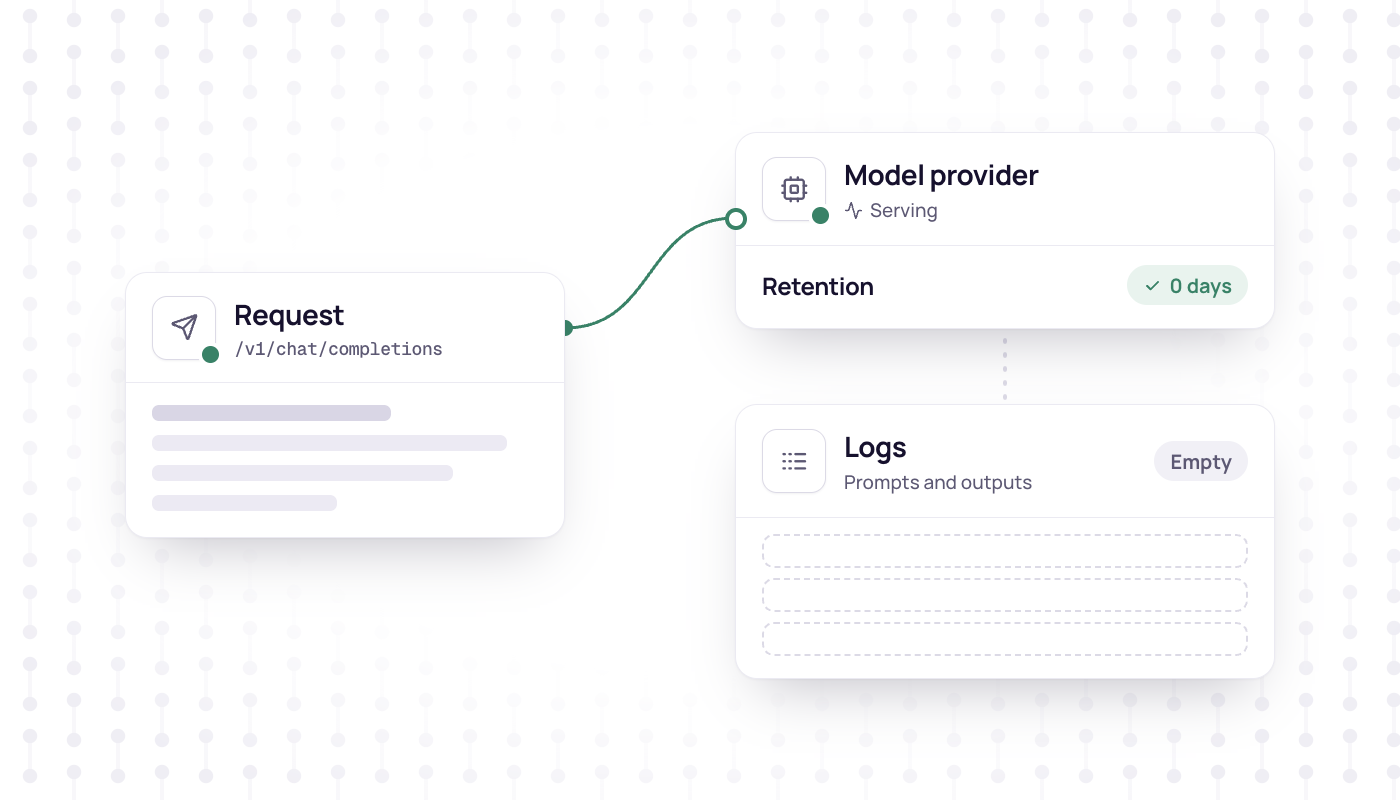
- Das Nodion AI Gateway routet nur zu Providern mit Sitz in der EU, die alle mit Zero Data Retention arbeiten; der AI-Inference-AVV gilt für Prompts und Outputs auf Nodion-gehosteten Modellen.
- Zero Data Retention (ZDR) ist kein Standard- oder Rechtsbegriff: Jeder LLM-API-Anbieter definiert ihn in seinen Docs, vergibt ihn auf eigene Weise und nennt eigene Ausnahmen.
- Standardmäßig hält OpenAI Abuse-Monitoring-Logs bis zu 30 Tage, Mistral Inputs und Outputs 30 rollierende Tage, Anthropics kommerzielle Policy löscht sie innerhalb von 30 Tagen, und die bezahlte Gemini Developer API hält sie 55 Tage.
- Auch mit ZDR nehmen OpenAI, Anthropic und Mistral zustandsbehaftete Features wie Dateien und Batches aus, und OpenAI und Anthropic können markierte Inhalte behalten; prüf also Umfang, Caching, Metadaten und Datenstandort pro Anbieter.
Zero Data Retention (ZDR) heißt im Kern: Ein LLM-API-Anbieter behält deine Prompts und Outputs nicht, sobald die Antwort zurück ist. Eine gemeinsame Definition gibt es aber nicht. Jeder Anbieter formuliert sie selbst, vergibt sie auf eigene Weise und nennt eigene Ausnahmen. Hier steht, was Anbieter standardmäßig speichern, wie OpenAI, Anthropic, Google, Mistral, OpenRouter und Azure ZDR handhaben, und eine Checkliste. Stand Oktober 2026.
Schon die Formulierungen unterscheiden sich: OpenRouter definiert ZDR so, dass ein Provider deine Daten „for any period of time“ nicht speichert, Anthropic so, dass es Prompts und Antworten nicht „at rest after the API response is returned“ speichert.
Was Anbieter standardmäßig speichern, und warum
Der Hauptgrund ist Missbrauchserkennung: Prompts und Outputs liegen in Logs, damit Verstöße gegen Nutzungsrichtlinien auffallen. Zustandsbehaftete Features wie Dateien, Batches oder Agents halten Daten länger.
- OpenAI: Abuse-Monitoring-Logs bis zu 30 Tage, sie können Prompts und Antworten enthalten. Die Responses API hält Application State standardmäßig 30 Tage.
- Anthropic: Laut kommerzieller Policy werden API-Inputs und -Outputs innerhalb von 30 Tagen gelöscht, mit Ausnahmen wie einer ZDR-Vereinbarung, der Files API, der Durchsetzung der Usage Policy oder gesetzlichen Pflichten.
- Mistral: Input und Output 30 rollierende Tage zur Missbrauchserkennung, außer ZDR ist aktiv; Daten der Agents API bis zur Schließung des Kontos.
- Gemini Developer API: im bezahlten Tarif 55 Tage zur Erkennung von Verstößen. Im unbezahlten Tarif darf Google Inhalte zur Verbesserung seiner Produkte nutzen, und menschliche Reviewer können sie lesen.
- Vertex AI (heute Gemini Enterprise Agent Platform): je nach Modellklasse und Vertrag, von nur auffälligen Prompts für bis zu 90 Tage bis zu allen Prompts und Antworten für bis zu 30 Tage.
Training ist eine eigene Frage: OpenAI, Anthropic und Google (bezahlte API und Vertex) trainieren laut eigenen Angaben standardmäßig nicht mit API-Daten; bei Mistral sind ZDR und Training-Opt-out getrennte Schalter.
Quellen, geprüft Oktober 2026: OpenAI Data Controls; Anthropic Retention, Training; Mistral Privacy Policy, ZDR; Google Gemini API Terms, Usage Policies, Vertex Abuse Monitoring; Definitionen: OpenRouter, Anthropic.
Anbieter für Anbieter
OpenAI
ZDR und Modified Abuse Monitoring (MAM) brauchen eine vorherige Freigabe durch OpenAI. Beide halten Kundeninhalte aus den Abuse-Logs heraus; ZDR behandelt zusätzlich store auf /v1/responses und /v1/chat/completions immer als false. Endpoints, die nicht ZDR-fähig sind, etwa Files, Vector Stores, Assistants, Conversations, Batches und Fine-Tuning, können weiter Zustand speichern. Bilder und Dateien, die als möglicher CSAM erkannt werden, bleiben auch unter ZDR für eine Prüfung gespeichert.
Anthropic
ZDR vereinbarst du über das Sales-Team, pro Organisation. Sie gilt für Messages und Token Counting API bei berechtigten Features. Batch Processing (29 Tage), Files API, das Code-Execution-Tool (Container-Daten bis 30 Tage), der MCP Connector und die Console liegen außerhalb, und als Covered Models eingestufte Modelle verlangen 30 Tage Retention. Die API blockiert nicht berechtigte Features nicht: Wer eines nutzt, verlässt für diese Daten die ZDR-Vereinbarung. Markierte Inhalte kann Anthropic bis zu 2 Jahre behalten.
Google: Gemini Developer API und Vertex AI
Googles ZDR-Seite zur Gemini Developer API sagt selbst: „If your workload requires guaranteed zero data retention or enterprise data processing agreements, use Vertex AI.“ Auf Vertex ist ZDR eine Reihe von Schritten, die du selbst gehst: Request-Response-Logging bleibt aus, bei der Interactions API setzt du store auf false, und wenn keine Daten auf Disk liegen dürfen, schaltest du Durable Caching pro Projekt ab. Grounding mit Google Search speichert Daten bis zu 3 Tage und lässt sich nicht abschalten; Google empfiehlt dann Web Grounding for Enterprise.
Mistral
Mistral (Paris) bietet ZDR nur bei Pay-as-you-go und nur für zustandslose API-Calls, etwa Chat Completions, Embeddings, OCR und Audio. Agents, Batch-Dateien, Conversations, Libraries und /v1/files sind ausgenommen. Du beantragst ZDR über das Help Center mit Begründung; Mistral entscheidet nach eigenem Ermessen, und freigegebene ZDR steht im Admin-Panel. Laut kommerziellen Bedingungen darf Mistral Daten aus Labs- oder Preview-Modellen zum Training nutzen, auch wenn du anderswo widersprochen hast, ZDR eingeschlossen.
OpenRouter
Bei OpenRouter ist ZDR ein Routing-Filter, den du einschaltest, pro Konto, Modellgruppe, Guardrail oder Request: Requests gehen nur an Endpoints, deren Policy OpenRouter als Zero Retention erfasst hat, und eine unklare Policy gilt als Speichern und Trainieren. Plugins und Tools wie die Websuche deckt der Filter nicht ab, und In-Memory-Caching zählt OpenRouter nicht als Speicherung. OpenRouter selbst speichert Prompts und Antworten nur, wenn du zustimmst oder ein Inhalt als mögliches CSAM markiert wird, und behält Metadaten wie Token-Zahlen und Latenz. Laut ZDR-Seite prüft es ab dem 27. Oktober 2026 alle Requests, ZDR-Traffic eingeschlossen, auf CSAM. In Business- und Enterprise-Plänen verarbeitet eu.openrouter.ai Prompts und Completions innerhalb der Region.
Azure OpenAI
Bei Azure-OpenAI-Modellen (heute „Foundry Models sold by Azure“) gehen Prompts und Completions nicht an OpenAI und trainieren ohne Erlaubnis keine Foundation-Modelle. Auffällige Inhalte für eine menschliche Prüfung liegen in der Geografie deiner Ressource. Das abzuschalten (Modified Abuse Monitoring) braucht eine Freigabe und steht nur Kunden mit Microsoft-Account-Team oder in berechtigten Programmen offen.
Quellen: OpenAI Data Controls; Anthropic ZDR; Google Gemini API ZDR, Vertex ZDR; Mistral ZDR, Commercial Terms; OpenRouter ZDR, Data Collection, Provider Logging; Azure Data Privacy, Limited Access.
Prompt Caching
Caches halten Teile eines Prompts kurz vor, damit Folge-Requests schneller sind. Laufzeit, Speicherort und die Haltung zu ZDR unterscheiden sich:
| Anbieter | Laufzeit | Wo | Haltung zu ZDR |
|---|---|---|---|
| OpenAI | Minuten bis 24 Stunden, je nach Modell und Einstellung | KV-Tensoren, auch im GPU-lokalen Speicher | „compatible with Zero Data Retention“ |
| Anthropic | 5 Minuten, bei Nutzung verlängert; 1 Stunde als Option | KV-Repräsentationen und Hashes im Speicher | ZDR-fähig |
| Vertex AI | Bis 24 Stunden, In-Memory und Durable standardmäßig an | Durable Cache auf Disk | Durable oder ganzes Caching pro Projekt abschaltbar |
| Gemini Developer API | Implizit 24 Stunden, explizit nach deiner TTL | Implizit nur im RAM | Implizit vereinbar; cached_content meiden |
| OpenRouter | Beim Provider | In-Memory-Caches der Provider | Gilt nicht als Speicherung |
OpenAI, Anthropic und Google isolieren Caches pro Organisation oder Projekt.
Quellen: OpenAI, Anthropic, Vertex, Gemini API, OpenRouter.
Datenstandort in der EU
Der Standort ist ein eigenes Versprechen neben ZDR, und jeder Anbieter regelt ihn anders:
- OpenAI: Die Region Europe (EWR und Schweiz) setzt eine Freigabe für MAM oder ZDR und ein Modified-Retention-Amendment voraus. Systemdaten wie Kontodaten, Metadaten und Nutzungsdaten sind ausgenommen.
- Anthropic: Die Data-Residency-Docs nennen für Inference
global(Standard) undus, als Workspace-Geo nurus. - Mistral: Der Standard-Endpoint sagt keinen Inference-Standort zu.
api.eu.mistral.aiverarbeitet in der EU, ohne zustandsbehaftete Features; Control-Plane-Metadaten können außerhalb der Region liegen. - Azure: Standard-Deployments verarbeiten in der gewählten Geografie, DataZone-Deployments in EU-Mitgliedstaaten, Global-Deployments in jeder Geografie.
- Gemini Developer API: Daten können „transiently or cached in any country“ liegen, in dem Google Einrichtungen hat.
Quellen: OpenAI, Anthropic, Mistral, Azure, Gemini API.
Was die DSGVO dazu sagt
Den Begriff ZDR kennt die DSGVO nicht, mehrere Artikel der Verordnung (EU) 2016/679 sind aber einschlägig:
- Art. 5 Abs. 1 lit. c, Datenminimierung: nur so viele personenbezogene Daten, wie der Zweck braucht.
- Art. 5 Abs. 1 lit. e, Speicherbegrenzung: nicht länger gespeichert als nötig.
- Art. 25 Abs. 2, Datenschutz durch Voreinstellungen, ausdrücklich auch für die Speicherfrist.
- Art. 28: Auftragsverarbeiter brauchen hinreichende Garantien, Unterauftragsverarbeiter eine Genehmigung, und der Vertrag (AVV) regelt Dauer, Weisungen und Löschung.
- Art. 44: Übermittlungen in Drittländer nur unter den Bedingungen von Kapitel V, Weiterübermittlungen eingeschlossen.
Kurze oder keine Speicherung heißt: weniger personenbezogene Daten für kürzere Zeit. Retention-Regeln gehören in den AVV, und Anbieter oder Unterauftragsverarbeiter außerhalb des EWR bringen Kapitel V ins Spiel. Das ist Hintergrund, keine Rechtsberatung.
Checkliste
- Standard-Retention: wie viele Tage, zu welchem Zweck?
- Abuse-Logs: immer oder nur bei Auffälligkeiten, menschliche Prüfung, Opt-out?
- Vergabe und Durchsetzung: Freigabe, Konfiguration oder Routing-Filter? Blockiert die API nicht berechtigte Features?
- Umfang: welche Endpoints abgedeckt sind, welche nicht (Files, Batch, Agents, Fine-Tuning)?
- Modelle: verlangt ein Modell Retention?
- Prompt Caching: Laufzeit, RAM oder Disk, abschaltbar?
- Training: Standard für bezahlte API, Gratis-Tarife, Feedback und Preview-Modelle.
- Markierte Inhalte und Legal Holds.
- Metadaten und Logs: Token-Zahlen, Latenz, IP-Adressen, Kontodaten.
- Datenstandort: Region für Inference und Speicherung, Standard oder Opt-in, Ausnahmen.
- Unterauftragsverarbeiter: veröffentlichte Liste, AVV nach Art. 28, Übermittlungsgrundlage nach Kapitel V.
- Tools von Dritten: Websuche, Code-Ausführung, Dateispeicher, MCP-Server und Plugins.
- Nachweis: in der Konsole sichtbar, im Vertrag oder nur zugesagt?
So handhabt es Nodion
Das Nodion AI Gateway (https://api.nodion.ai/v1) routet nur zu Providern mit Sitz in der EU, die alle mit Zero Data Retention arbeiten. Ein eigenes Konto bei diesen Providern brauchst du nicht: Jeder Request läuft mit deinem Nodion-API-Key über Nodion, und in den AI-Settings des Projekts erlaubst oder schließt du Provider aus. Einige Punkte der Checkliste:
- Responses API: Nodion speichert keine Responses.
storewird ignoriert, und es gibt keinprevious_response_idund keinGET /v1/responses/{id}. - AVV: Der AI-Inference-AVV gilt für Prompts und Outputs nur auf Nodion-gehosteten Modellen. Geroutete Provider liegen außerhalb.
- AI Tools: Websuche, News und Fetch liegen außerhalb dieses AVV, und die Aussage zu Zero Data Retention oben betrifft Modell-Provider, nicht diese Tools.
- Metadaten: Für Nodion-gehostete Modelle nennt der AVV die Betriebsmetadaten, die für Abrechnung und Sicherheit bleiben: Zeitstempel, Request-ID, Modell, Status, Token-Zahlen, Latenz und Betrag.
Mehr: Modelle und Provider unter AI Inference, Keys und Settings in den Docs, Pläne unter AI Coding Plans, dazu die Vergleiche OpenRouter-Alternativen und AI Coding Plans.
Quellen: AI-Inference-Docs, AI-API-Referenz: Responses, AI-Inference-AVV, § 1 und § 4.
Häufige Fragen
Welche LLM-API bietet Zero Data Retention in der EU?
Das Nodion AI Gateway routet nur zu Providern mit Sitz in der EU, die alle mit Zero Data Retention arbeiten, und du rufst jedes Modell mit einem Nodion-API-Key auf. Mistral bietet ZDR bei Pay-as-you-go für zustandslose Calls nach Freigabe, dazu einen EU-Endpoint zum Zuschalten; die Region Europe von OpenAI setzt eine Freigabe für Modified Abuse Monitoring oder ZDR voraus.
Was bedeutet Zero Data Retention bei einer LLM-API?
Im Kern, dass der Anbieter deine Prompts und Outputs nicht behält, sobald die Antwort zurück ist. Eine gemeinsame Definition gibt es nicht: Jeder Anbieter legt Umfang und Ausnahmen selbst fest, etwa zustandsbehaftete Features, Caches und markierte Inhalte.
Verträgt sich Prompt Caching mit Zero Data Retention?
OpenAI, Anthropic und die Gemini Developer API behandeln ihre kurzlebigen Caches als vereinbar mit ZDR, und OpenRouter zählt In-Memory-Caching nicht als Speicherung. Auf Vertex AI speichert der Durable Cache Daten bis zu 24 Stunden auf Disk, wenn du ihn nicht pro Projekt abschaltest.
Verlangt die DSGVO Zero Data Retention?
Den Begriff nutzt die DSGVO nicht. Sie verlangt Datenminimierung und Speicherbegrenzung (Art. 5), Datenschutz durch Voreinstellungen (Art. 25) und einen Auftragsverarbeitungsvertrag (Art. 28), und kurze oder keine Speicherung hilft dabei. Das ist keine Rechtsberatung.