
Zero data retention en APIs de LLM: qué significa y cómo comprobarla
 Niklas KarolyFundador de Nodion
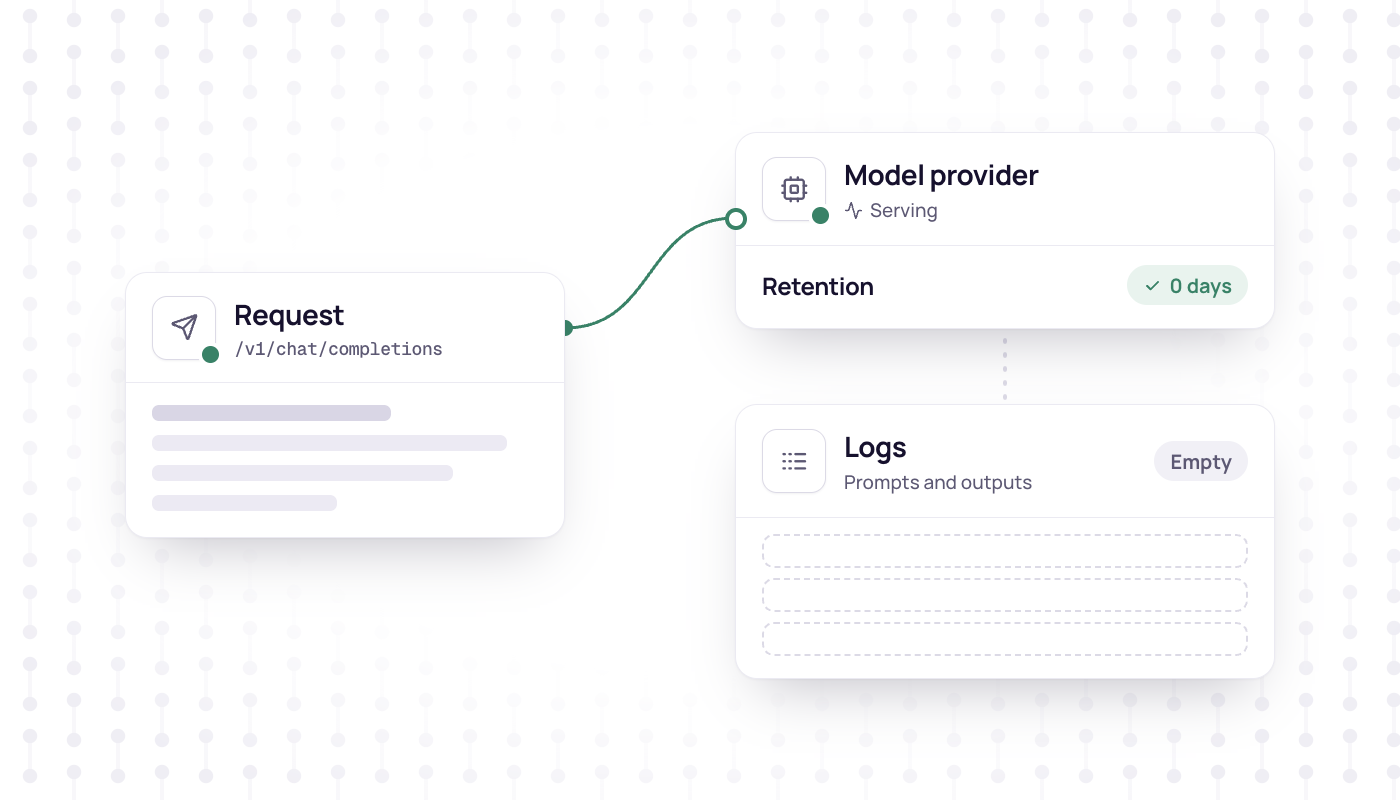
En resumen
- El Nodion AI Gateway solo enruta a proveedores con sede en la UE, todos con zero data retention; el DPA de AI Inference cubre prompts y salidas en los modelos alojados por Nodion.
- La zero data retention (ZDR) no es un estándar ni un término jurídico: cada proveedor de APIs de LLM la define en su propia documentación, la concede a su manera y enumera sus propias excepciones.
- Por defecto, OpenAI conserva los logs de monitorización de abusos hasta 30 días, Mistral conserva entradas y salidas durante 30 días móviles, la política comercial de Anthropic las elimina en un plazo de 30 días y la Gemini Developer API de pago las conserva 55 días.
- Incluso con ZDR, OpenAI, Anthropic y Mistral excluyen funciones con estado como archivos y batches, y OpenAI y Anthropic pueden conservar el contenido marcado, así que comprueba el alcance, el caching, los metadatos y la ubicación de los datos de cada proveedor.
Zero data retention (ZDR) significa, en esencia, que un proveedor de API de LLM no conserva tus prompts ni tus salidas una vez devuelta la respuesta. Sin embargo, no existe una definición común. Cada proveedor redacta la suya, la concede a su manera y enumera sus propias excepciones. A continuación: qué guardan los proveedores por defecto, cómo gestionan la ZDR OpenAI, Anthropic, Google, Mistral, OpenRouter y Azure, y una lista de comprobación. Datos a octubre de 2026.
Incluso la redacción difiere: Para OpenRouter, significa que un proveedor no guarda tus datos “for any period of time”; para Anthropic, que no guarda prompts ni respuestas “at rest after the API response is returned”.
Qué guardan los proveedores por defecto y por qué
El motivo principal es la monitorización de abusos: los prompts y las salidas se conservan en logs para poder detectar infracciones de las políticas de uso. Las funciones con estado, como archivos, batches o agentes, conservan los datos durante más tiempo.
- OpenAI: logs de monitorización de abusos de hasta 30 días, que pueden contener prompts y respuestas. La Responses API conserva el estado de la aplicación 30 días por defecto.
- Anthropic: su política comercial elimina las entradas y salidas de la API en un plazo de 30 días, con excepciones como un acuerdo de ZDR, la Files API, la aplicación de la Usage Policy o la ley.
- Mistral: entradas y salidas durante 30 días móviles para la monitorización de abusos, salvo que la ZDR esté activada; los datos de la Agents API, hasta que cierres la cuenta.
- Gemini Developer API: 55 días en el nivel de pago para detectar infracciones de las políticas. En el nivel gratuito, Google puede usar el contenido para mejorar sus productos, y revisores humanos pueden leerlo.
- Vertex AI (ahora Gemini Enterprise Agent Platform): según la clase de modelo y el acuerdo, puede conservar solo los prompts marcados durante un máximo de 90 días o todos los prompts y respuestas durante un máximo de 30 días.
El entrenamiento es otra cuestión: OpenAI, Anthropic y Google (API de pago y Vertex) afirman que no entrenan con datos de la API por defecto; en Mistral, la ZDR y la exclusión del entrenamiento (opt-out) son controles separados.
Fuentes, consultadas en octubre de 2026: OpenAI controles de datos; Anthropic retención, entrenamiento; Mistral política de privacidad, ZDR; Google términos de la Gemini API, políticas de uso, monitorización de abusos en Vertex; definiciones: OpenRouter, Anthropic.
Proveedor por proveedor
OpenAI
La ZDR y el Modified Abuse Monitoring (MAM) requieren la aprobación previa de OpenAI. Ambos dejan el contenido de los clientes fuera de los logs de monitorización de abusos; la ZDR, además, trata store en /v1/responses y /v1/chat/completions como false. Los endpoints que no son aptos para ZDR, como archivos, vector stores, asistentes, conversaciones, batches y fine-tuning, pueden seguir almacenando estado. Las imágenes y archivos marcados como posible CSAM se conservan para su revisión incluso con ZDR.
Anthropic
La ZDR se acuerda con el equipo comercial, por organización. Cubre las APIs Messages y Token Counting para las funciones aptas. El procesamiento por lotes (29 días), la Files API, la herramienta de ejecución de código (datos del contenedor hasta 30 días), el conector MCP y la Console quedan fuera, y los modelos designados como Covered Models exigen una retención de 30 días. La API no bloquea las funciones no aptas: si usas una, los datos correspondientes quedan fuera del acuerdo de ZDR. El contenido marcado puede conservarse hasta 2 años.
Google: Gemini Developer API y Vertex AI
La propia página de ZDR de Google para la Gemini Developer API dice: “If your workload requires guaranteed zero data retention or enterprise data processing agreements, use Vertex AI.” En Vertex, la ZDR es una serie de pasos que das tú: mantener desactivado el logging de peticiones y respuestas, poner store a false en la Interactions API y, si no se pueden almacenar datos en reposo, desactivar el durable caching por proyecto. El grounding con Google Search conserva datos hasta 3 días y no se puede desactivar; en su lugar, Google recomienda Web Grounding for Enterprise.
Mistral
Mistral (París) ofrece ZDR solo en pago por uso (pay-as-you-go) y solo para llamadas a la API sin estado, como chat completions, embeddings, OCR y audio. Quedan excluidos los agentes, los archivos de batch, las conversaciones, las librerías y /v1/files. La solicitas en el Help Center explicando tus motivos; Mistral decide a su discreción, y la ZDR aprobada aparece en el panel de administración. Los términos comerciales de Mistral le permiten entrenar con datos de los modelos Labs o Preview aunque te hayas excluido (opt-out) por otras vías, también mediante ZDR.
OpenRouter
En OpenRouter, la ZDR es un filtro de enrutamiento que activas tú, por cuenta, grupo de modelos, guardrail o petición: las peticiones solo van a endpoints cuya política OpenRouter tiene registrada como zero retention, y una política poco clara cuenta como retención y entrenamiento. No cubre plugins ni herramientas como la búsqueda web, y OpenRouter no considera retención el caching en memoria. OpenRouter solo guarda prompts y respuestas si tú lo activas o si un contenido se marca como posible CSAM, y conserva metadatos como el número de tokens y la latencia. Su página de ZDR anunció la revisión de todas las peticiones para detectar CSAM, incluido el tráfico ZDR, a partir del 27 de octubre de 2026. En los planes Business y Enterprise, eu.openrouter.ai procesa los prompts y las completions dentro de la región.
Azure OpenAI
En los modelos de Azure OpenAI (ahora “Foundry Models sold by Azure”), los prompts y las completions no están disponibles para OpenAI ni se usan para entrenar modelos fundacionales sin permiso. El contenido marcado que se retiene para revisión humana se almacena en la geografía de tu recurso. Desactivarlo (modified abuse monitoring) requiere aprobación y está limitado a clientes con un equipo de cuenta de Microsoft o en un programa apto.
Fuentes: OpenAI controles de datos; Anthropic ZDR; Google ZDR de la Gemini API, ZDR de Vertex; Mistral ZDR, términos comerciales; OpenRouter ZDR, recogida de datos, logging de los proveedores; Azure privacidad de los datos, acceso limitado.
Prompt caching
Las cachés guardan partes de un prompt durante poco tiempo para que las peticiones siguientes sean más rápidas. La duración, el almacenamiento y la postura respecto a la ZDR varían:
| Proveedor | Duración | Dónde | Postura sobre la ZDR |
|---|---|---|---|
| OpenAI | De minutos a 24 horas, según el modelo y la configuración | Tensores KV, también en almacenamiento local de la GPU | “compatible with Zero Data Retention” |
| Anthropic | 5 minutos, renovados con cada uso; 1 hora como opción | Representaciones KV y hashes en memoria | Apto para ZDR |
| Vertex AI | Hasta 24 horas, en memoria y durable, ambas activadas por defecto | Caché durable en reposo | Se puede desactivar la caché durable o todo el caching por proyecto |
| Gemini Developer API | Implícita 24 horas, explícita según tu TTL | Implícita solo en RAM | La implícita es compatible; evita cached_content |
| OpenRouter | En el proveedor | Cachés en memoria de los proveedores | No cuenta como retención |
OpenAI, Anthropic y Google aíslan las cachés por organización o proyecto.
Fuentes: OpenAI, Anthropic, Vertex, Gemini API, OpenRouter.
Ubicación de los datos en la UE
La ubicación es un compromiso distinto de la ZDR, y cada proveedor la plantea de forma diferente:
- OpenAI: la región Europe (EEE y Suiza) requiere aprobación para MAM o ZDR y una enmienda Modified Retention. Los datos del sistema, como los datos de la cuenta, los metadatos y los datos de uso, quedan excluidos.
- Anthropic: la documentación de residencia de datos indica
global(por defecto) yuspara la inferencia, yuscomo única geo del workspace. - Mistral: el endpoint por defecto no se compromete con ninguna ubicación para la inferencia.
api.eu.mistral.aiprocesa en la UE, sin funciones con estado; los metadatos del control plane pueden tratarse fuera de la región. - Azure: los despliegues Standard procesan en la geografía elegida, los DataZone en estados miembros de la UE y los Global en cualquier geografía.
- Gemini Developer API: los datos “may be stored transiently or cached in any country” en el que Google tenga instalaciones.
Fuentes: OpenAI, Anthropic, Mistral, Azure, Gemini API.
Qué dice el RGPD
El RGPD no usa el término ZDR, pero varios artículos del Reglamento (UE) 2016/679 son aplicables:
- Art. 5.1.c), minimización de datos: solo los datos personales necesarios para la finalidad.
- Art. 5.1.e), limitación del plazo de conservación: no conservarlos más tiempo del necesario.
- Art. 25.2, protección de datos por defecto, que incluye expresamente el plazo de conservación.
- Art. 28: los encargados del tratamiento deben ofrecer garantías suficientes, los subencargados necesitan autorización, y el contrato de encargo del tratamiento (DPA) fija la duración, las instrucciones y la supresión.
- Art. 44: transferencias a terceros países solo en las condiciones del capítulo V, transferencias ulteriores incluidas.
Una retención breve o nula significa menos datos personales almacenados durante menos tiempo; las condiciones de retención van en el DPA; los proveedores o subencargados fuera del EEE hacen entrar en juego el capítulo V. Esto es información de contexto, no asesoramiento jurídico.
Lista de comprobación
- Retención por defecto: ¿cuántos días y con qué finalidad?
- Logs de abusos: ¿siempre o solo con contenido marcado? ¿Revisión humana? ¿Puedes excluirte?
- Cómo se concede y se aplica la ZDR: ¿aprobación, configuración o filtro de enrutamiento? ¿Bloquea la API las funciones no aptas?
- Alcance: ¿qué endpoints están cubiertos y cuáles excluidos (archivos, batch, agentes, fine-tuning)?
- Modelos: ¿algún modelo exige retención?
- Prompt caching: duración, ¿en memoria o en disco? ¿Se puede desactivar?
- Entrenamiento: valores por defecto para la API de pago, los niveles gratuitos, el feedback y los modelos en preview.
- Contenido marcado y retenciones legales (legal holds).
- Metadatos y logs: número de tokens, latencia, direcciones IP, datos de la cuenta.
- Ubicación de los datos: región de inferencia y de almacenamiento, por defecto u opt-in, exclusiones.
- Subencargados: lista publicada, DPA según el art. 28, mecanismo de transferencia del capítulo V.
- Herramientas de terceros: búsqueda web, ejecución de código, almacenamiento de archivos, servidores MCP y plugins.
- Cómo comprobarlo: ¿visible en la consola, por escrito en el contrato o solo prometido?
Cómo lo gestiona Nodion
El Nodion AI Gateway (https://api.nodion.ai/v1) solo enruta a proveedores con sede en la UE, todos con zero data retention. No necesitas cuenta en esos proveedores: cada petición pasa por Nodion con tu clave de API de Nodion, y en los ajustes de IA del proyecto permites o excluyes proveedores. Algunos puntos de la lista de comprobación:
- Responses API: Nodion no almacena respuestas.
storese ignora, y no hayprevious_response_idniGET /v1/responses/{id}. - DPA: el DPA de AI Inference cubre prompts y salidas solo en los modelos alojados por Nodion. Los proveedores a los que se enruta quedan fuera.
- AI Tools: la búsqueda web, las noticias y fetch quedan fuera de ese DPA, y lo dicho arriba sobre zero data retention se refiere a los proveedores de modelos, no a estas herramientas.
- Metadatos: para los modelos alojados por Nodion, el DPA enumera los metadatos operativos que se conservan para facturación y seguridad: marcas de tiempo, IDs de petición, modelo, estado, número de tokens, latencia e importe.
Más información: modelos y proveedores en AI Inference, claves y ajustes en la documentación, planes en AI Coding Plans, y las comparativas de alternativas a OpenRouter y de AI coding plans.
Fuentes: documentación de AI Inference, referencia de la API de IA: Responses, DPA de AI Inference, § 1 y § 4.
Preguntas frecuentes
¿Qué API de LLM ofrece zero data retention en la UE?
El Nodion AI Gateway solo enruta a proveedores con sede en la UE, todos con zero data retention, y llamas a todos los modelos con una sola clave de API de Nodion. Mistral ofrece ZDR en pago por uso para llamadas sin estado, previa aprobación, además de un endpoint en la UE opcional (opt-in); la región Europe de OpenAI requiere aprobación para Modified Abuse Monitoring o ZDR.
¿Qué significa zero data retention en una API de LLM?
En esencia, que el proveedor no conserva tus prompts ni tus salidas después de devolver la respuesta. No existe una definición común: cada proveedor fija su propio alcance y sus excepciones, como las funciones con estado, las cachés y el contenido marcado.
¿El prompt caching rompe la zero data retention?
OpenAI, Anthropic y la Gemini Developer API consideran sus cachés de corta duración compatibles con la ZDR, y OpenRouter no considera retención el caching en memoria. En Vertex AI, la caché durable almacena datos en reposo hasta 24 horas, salvo que la desactives por proyecto.
¿Exige el RGPD zero data retention?
El RGPD no usa ese término. Exige minimización de datos y limitación del plazo de conservación (art. 5), protección de datos por defecto (art. 25) y un contrato con el encargado del tratamiento (art. 28), y una retención breve o nula ayuda a cumplirlos. Esto no es asesoramiento jurídico.